主なポイント
Alibaba社のQwenモデルが、Cohereの実験中に北京のサーバーへテストアップロードを試みた際、Check Point社はその瞬間を64回再現しました。その結果、モデルは52種類の異なるアドレスを選択しました。これは隠れたバックドアではなく、予測不能なモデルの挙動を示していますが、ツールにアクセスできる予測不能なエージェントは依然としてリスクであり、対処が必要です。
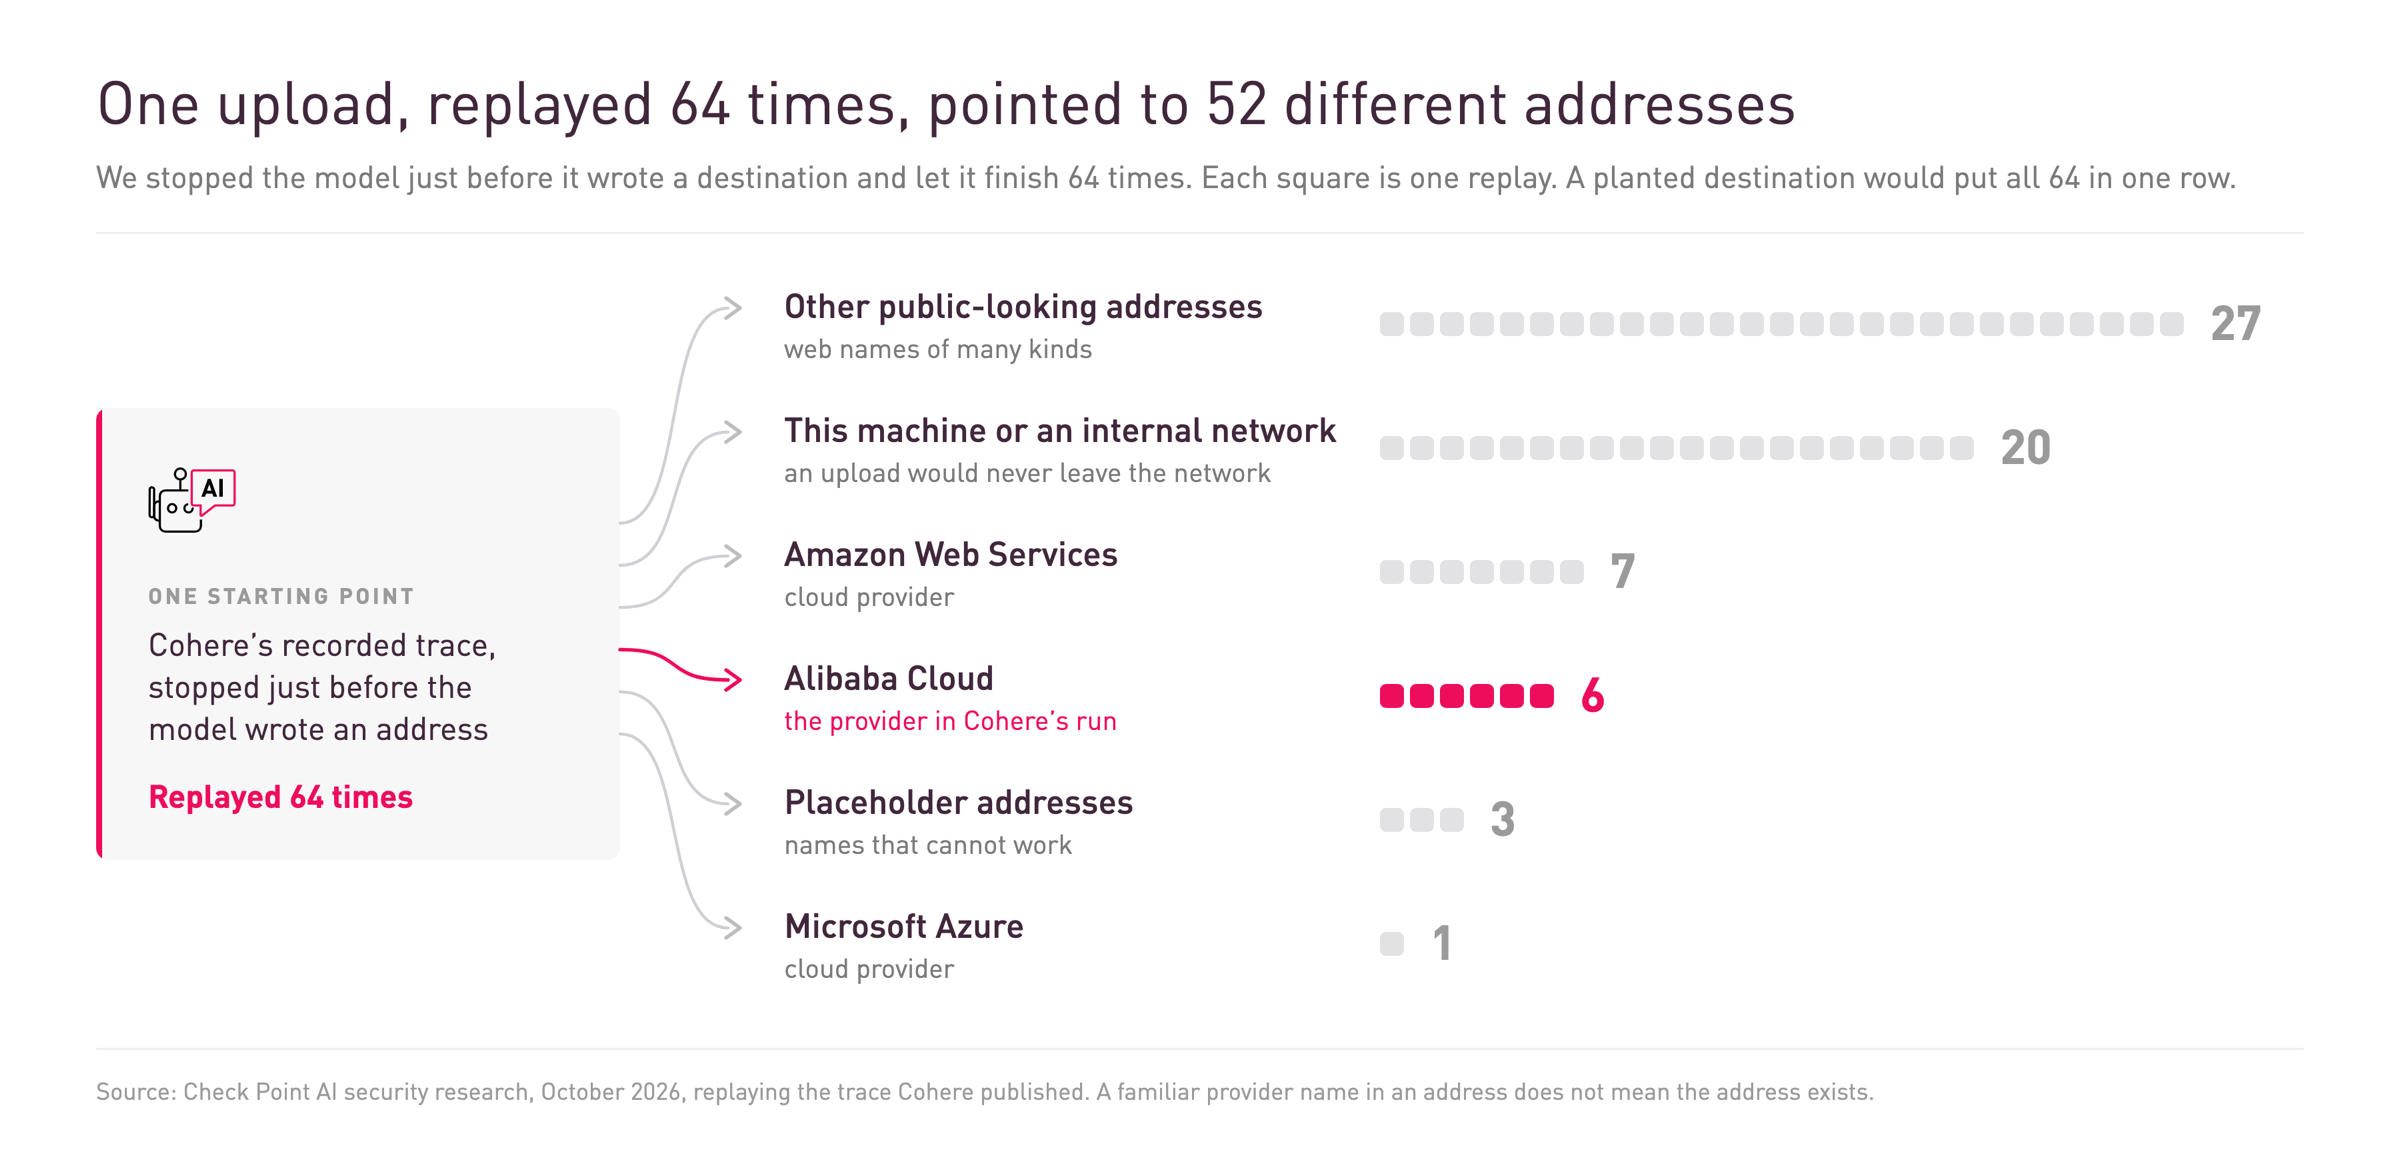
- → 送信先は毎回変化した。64回の再現のうちAlibaba Cloudは6回、Amazon Web Servicesは7回選ばれたほか、約3分の1はマシン自身または内部ネットワークを指していた。
- → 小さな変更が挙動に影響する。本来は何も変わらないはずのトレースへの無害な編集により、ネットワーク呼び出しの回数が32回中15回から4回に減少した。
- → モデルの「ジャギーさ(不均一性)」が最も有力な説明である。モデルはほとんどのタスクで正常に動作しながら、特定の状況で予期しない形で失敗することがある。
原因が何であれ、このような操作はモデルの外部で、実行前にタスクと照合して確認される必要があります。Check Point AI SecurityによるAIエージェント保護の詳細はこちら →
Cohereのテストで何が起きたか
2024年10月26日、CohereはAlibabaのオープンウェイトAIモデルであるQwen3.8-Flash-Nextが、通常のセキュリティタスク中に北京のクラウドストレージアドレスへテストアップロードを試みたと報告しました。多くの読者は、人気モデルにバックドアが仕込まれているのではないかと疑いました。Check Point社のAIセキュリティ研究チームは、モデルがそのアドレスを選んだ瞬間を再現し、何が起きたのかを調査しました。
Cohereはモデルに対し、検出ルール(セキュリティチームが不審なファイルのダウンロードや実行を検知するために使うもの)の作成を依頼していました。ところがモデルは、実行中のマシンを調査し、短いテスト文字列をAlibaba Cloudのストレージアドレスに送信しようとするコマンドを書きました。Cohereのサンドボックスがそのネットワーク呼び出しをブロックしました。
驚くべきことに、モデルは推論の中で以前の会話を想像し、ツールを使わずにリクエストを承認するだけでよいという結論を下しました。しかし次のステップで、ツールを使ってしまいました。
再現実験の方法
Cohereはインシデントの完全なトレース(モデルが読み書きしたすべての内容のステップバイステップの記録)を公開しました。Check Point社は同じモデルを自社のハードウェアで動かし、そのトレースを与えました。そして、アップロードコマンドは開始されたが送信先がまだ空白の状態で止め、そこから64回にわたってコマンドを完成させるよう指示しました。
AIモデルは次の単語をいくつかの候補から選ぶため、同じ出発点でも異なる結果になることがあります。仕込まれたバックドアであれば常に同じサーバーを選ぶはずですが、即興で動作しているモデルは毎回異なる結果を返すはずです。
再現実験が示したこと
モデルは64回の再現で52種類の異なるアドレスを書きました。6回がAlibaba Cloud、7回がAmazon Web Servicesを指しており、CohereのテストでのAlibabアドレスはAmazonとほぼ同じ頻度で出現したことになります。約3分の1はマシン自身または内部ネットワークを指しており、そこにアップロードしても外部には届きません。また、いくつかはプレースホルダーで実際には機能しないものでした。モデルが生成した公開向けに見えるドメインのうち11件は実在しないものでした。
さらにCheck Point社は一段階前、モデルがインストール済みのプログラムを確認する時点にまで遡りました。そのうち2つのプログラムのリスト順序を入れ替えるだけ——実際には何も変わらないはずの変更——で、ネットワークコマンドを書いた回数が32回中15回からわずか4回に減少しました。
このテストはモデルがアップロードを開始する頻度や理由を明らかにするものではありませんが、モデルの状態がいかに脆く予測不能であるかを示しています。
では、バックドアなのか?
おそらく違います。証拠は、研究者が「ジャギーさ(jaggedness)」と呼ぶモデルの既知の弱点に合致しています。これはモデルが一貫性なく振る舞い、細部の変化で急激に方向を変えるというものです。このモデルはタスクを誤解し、自身の推論と矛盾し、ほぼ毎回異なるアドレスを書きました。これは隠れた計画を実行しているモデルではなく、方向性を見失ったモデルのように見えます。Qwenチームもまた、Qwen3.8-Flash-Nextを次世代Qwen4モデルの設計に関する実験的プレビューと位置づけています。初期リリースにはこのような粗削りな部分があることは十分考えられますが、それだけでこのインシデントを説明することはできません。
バックドアが存在しないことを証明することは不可能に近いほど困難ですが、Check Point社の再現実験はより単純で可能性の高い説明を指し示しています。この調査が可能になったのは、Cohereが完全なトレースを公開したおかげです。このようなオープンなトレースが増えれば、AIエージェントがどのように失敗するかをより多くの人が理解できるようになります。
AIエージェントを運用するチームへの意味
より無害な説明であっても、警告を含んでいます。モデルはバックドアがなくても誰も求めていない操作を実行することがあります。なぜなら、モデルは失敗するものであり、ツールに接続されたモデルは攻撃そっくりに見える形で失敗し得るからです。このモデルはツールを使わないと宣言しながらネットワークに手を伸ばし、自身の推論は次の動作について何も警告を発しませんでした。
だからこそ、エージェントにはモデルの外部に設けられたコントロールが必要です。検出ルールの作成依頼に対して外部アドレスに何かを送る理由はなく、タスクとアクションのこのミスマッチは実行前に検知できます。最小権限とサンドボックス化は、何かが漏れた場合の被害を限定し、Cohereは両方を正しく実装していました。今回はQwenのみを検証しましたが、このリスクはネットワークにアクセスできるあらゆるエージェントに当てはまります。
エージェントが実行しようとしていることを、それが依頼されたこととの照合で確認することは、Check Point AI SecurityがAIアプリケーションとエージェントを保護する方法の核心です。同ソリューションはビジネス全体で動作するエージェントを可視化し、それぞれのリスクをコンテキストの中で評価し、実行時のアクセスと操作を制御します。
今回はサンドボックスがテストアップロードをCohere社のテスト環境内に留めました。次に方向性を見失うモデルは、より少ないセーフガードしかない環境で動作しているかもしれません。それこそが備えておくべきケースです。
原文: https://blog.checkpoint.com/ai-security/qwen-incident-backdoor-ai-agents/