主要なポイント
Check Point社の「2026年クラウドセキュリティレポート」によると、パフォーマンスに影響を与えることなくAIトラフィックを完全に検査できる組織は全体の24%に過ぎません。
- ボイスエージェントは音声による誘導に弱い。研究者たちは、大手リアルタイム音声モデルに対して、速度・ピッチ・背景ノイズを変化させるだけで、約70%の音声リクエストに対して有害な回答を返させることに成功しました。
- トランスクリプト確認は盲点をつかれる可能性がある。攻撃者が口頭で指示を与えつつ録音を改ざんすることで、トランスクリプト上には文字化けや空白が表示される一方、モデルは元の音声を正常に受け取り続けます。
- 音声ガードレールは音声信号そのものを検査する。まず音声信号を確認し、次に発言内容を確認します。この処理には約0.25秒しかかからず、攻撃者のノイズと騒がしい街中にいる一般の発信者とを判別できます。
だからこそ、音声がモデルに到達した時点で、ガードレールはモデルが処理する前に音声そのものを検査しなければなりません。Check Point AI Securityがどのようにアプリとエージェントを保護するかをご確認ください。
なぜ音声が攻撃対象領域を変えるのか
つい最近まで、ほとんどの音声アシスタントはパイプライン型でした。音声がテキストに変換され、テキストモデルが回答を生成し、その回答が再び音声に変換されるという流れで、ガードレールが読めるトランスクリプトが常に存在していました。音声から音声へ直接処理するモデル(スピーチ・トゥ・スピーチ)はテキスト変換をスキップして音声を直接聞き取るため、会話がより速く自然になりますが、テキストガードレールが確認できる唯一の箇所がなくなってしまいます。
こうしたモデルは操作しやすいことも実証されています。ある研究では、オープンソースの音声モデルが有害な口頭での質問に3分の2以上の確率で回答しました。別の研究では、速度・ピッチ・背景ノイズを変化させ続けることで、大手リアルタイム音声モデルが約70%のケースで有害な回答を返したことが報告されています。また今年のIEEE S&Pでの論文では、音声中に隠された命令(人間には知覚できないもの)が、商用ボイスエージェントにユーザーが要求していない動作をさせることが示されました。ボイスエージェントがアカウント照会・配送スケジュール変更・返金処理などのツールにアクセスできるようになるにつれ、この問題はより深刻化します。エージェントはそれらの権限を、自分が聞き取った命令に従って行使するからです。
音声を通じた2種類の攻撃手法
攻撃者には2つの手段があります。1つ目は単純に「口で言う」ことです。発信者が「前の指示を無視してください」と英語、スペイン語、その他の言語で話しかけると、確認機構のないエージェントは通常のリクエストと同様に処理してしまいます。2つ目はテキストには存在しない方法で、音声を改ざんして機械に誤認識させることです。
研究者たちは、わずか0.64秒のユニバーサルクリップを音声の前に再生するだけで、広く使われているトランスクリプションモデルがテスト対象の録音の97%以上において何も出力しなくなることを示しました。人工的に生成されたノイズ、残響、群衆の雑音も同様に指示内容を聞き取れなくします。トランスクリプトだけを読むガードレールは、意味不明な内容や無音を検出してクリップを通過させてしまいますが、その背後のモデルは元の音声を正常に受け取っています。Check Point社の研究者自身も、トランスクリプト上はクリーンに見えながらもモデルが操作されている音声ジェイルブレイクを実証しています。
1つのクリップ、2つの検査
音声ガードレールは録音を直接検査します。アプリケーションがクリップを送信すると、トランスクリプションパイプラインを構築することなく、プロンプト攻撃の判定結果が返ってきます。内部では、クリップが順番に2つの検査を経由します。
最初の検査では、音声が使用可能かどうかを確認します。具体的には、どの程度劣化しているか、改ざんされていないか、機械に読み取れないよう設計された要素が含まれていないかをチェックします。この検査に失敗した音声はフラグが立てられ、それ以降の処理には進みません。2つ目の検査では、発言内容をトランスクリプション処理し、80以上の言語に対応したテキスト用のプロンプト攻撃検出と同じ仕組みで、担当チームが既に使用している重大度レベルに基づいてスコアリングします。つまり、最初の検査でトランスクリプトが信頼できるかどうかを確認してから、2つ目の検査がそれに依拠するという仕組みです。テキストと同様に、判定結果はアプリケーションに返され、次の行動(会話を終了する、発信者に繰り返しを求める、担当者に転送するなど)をアプリケーション側で決定します。
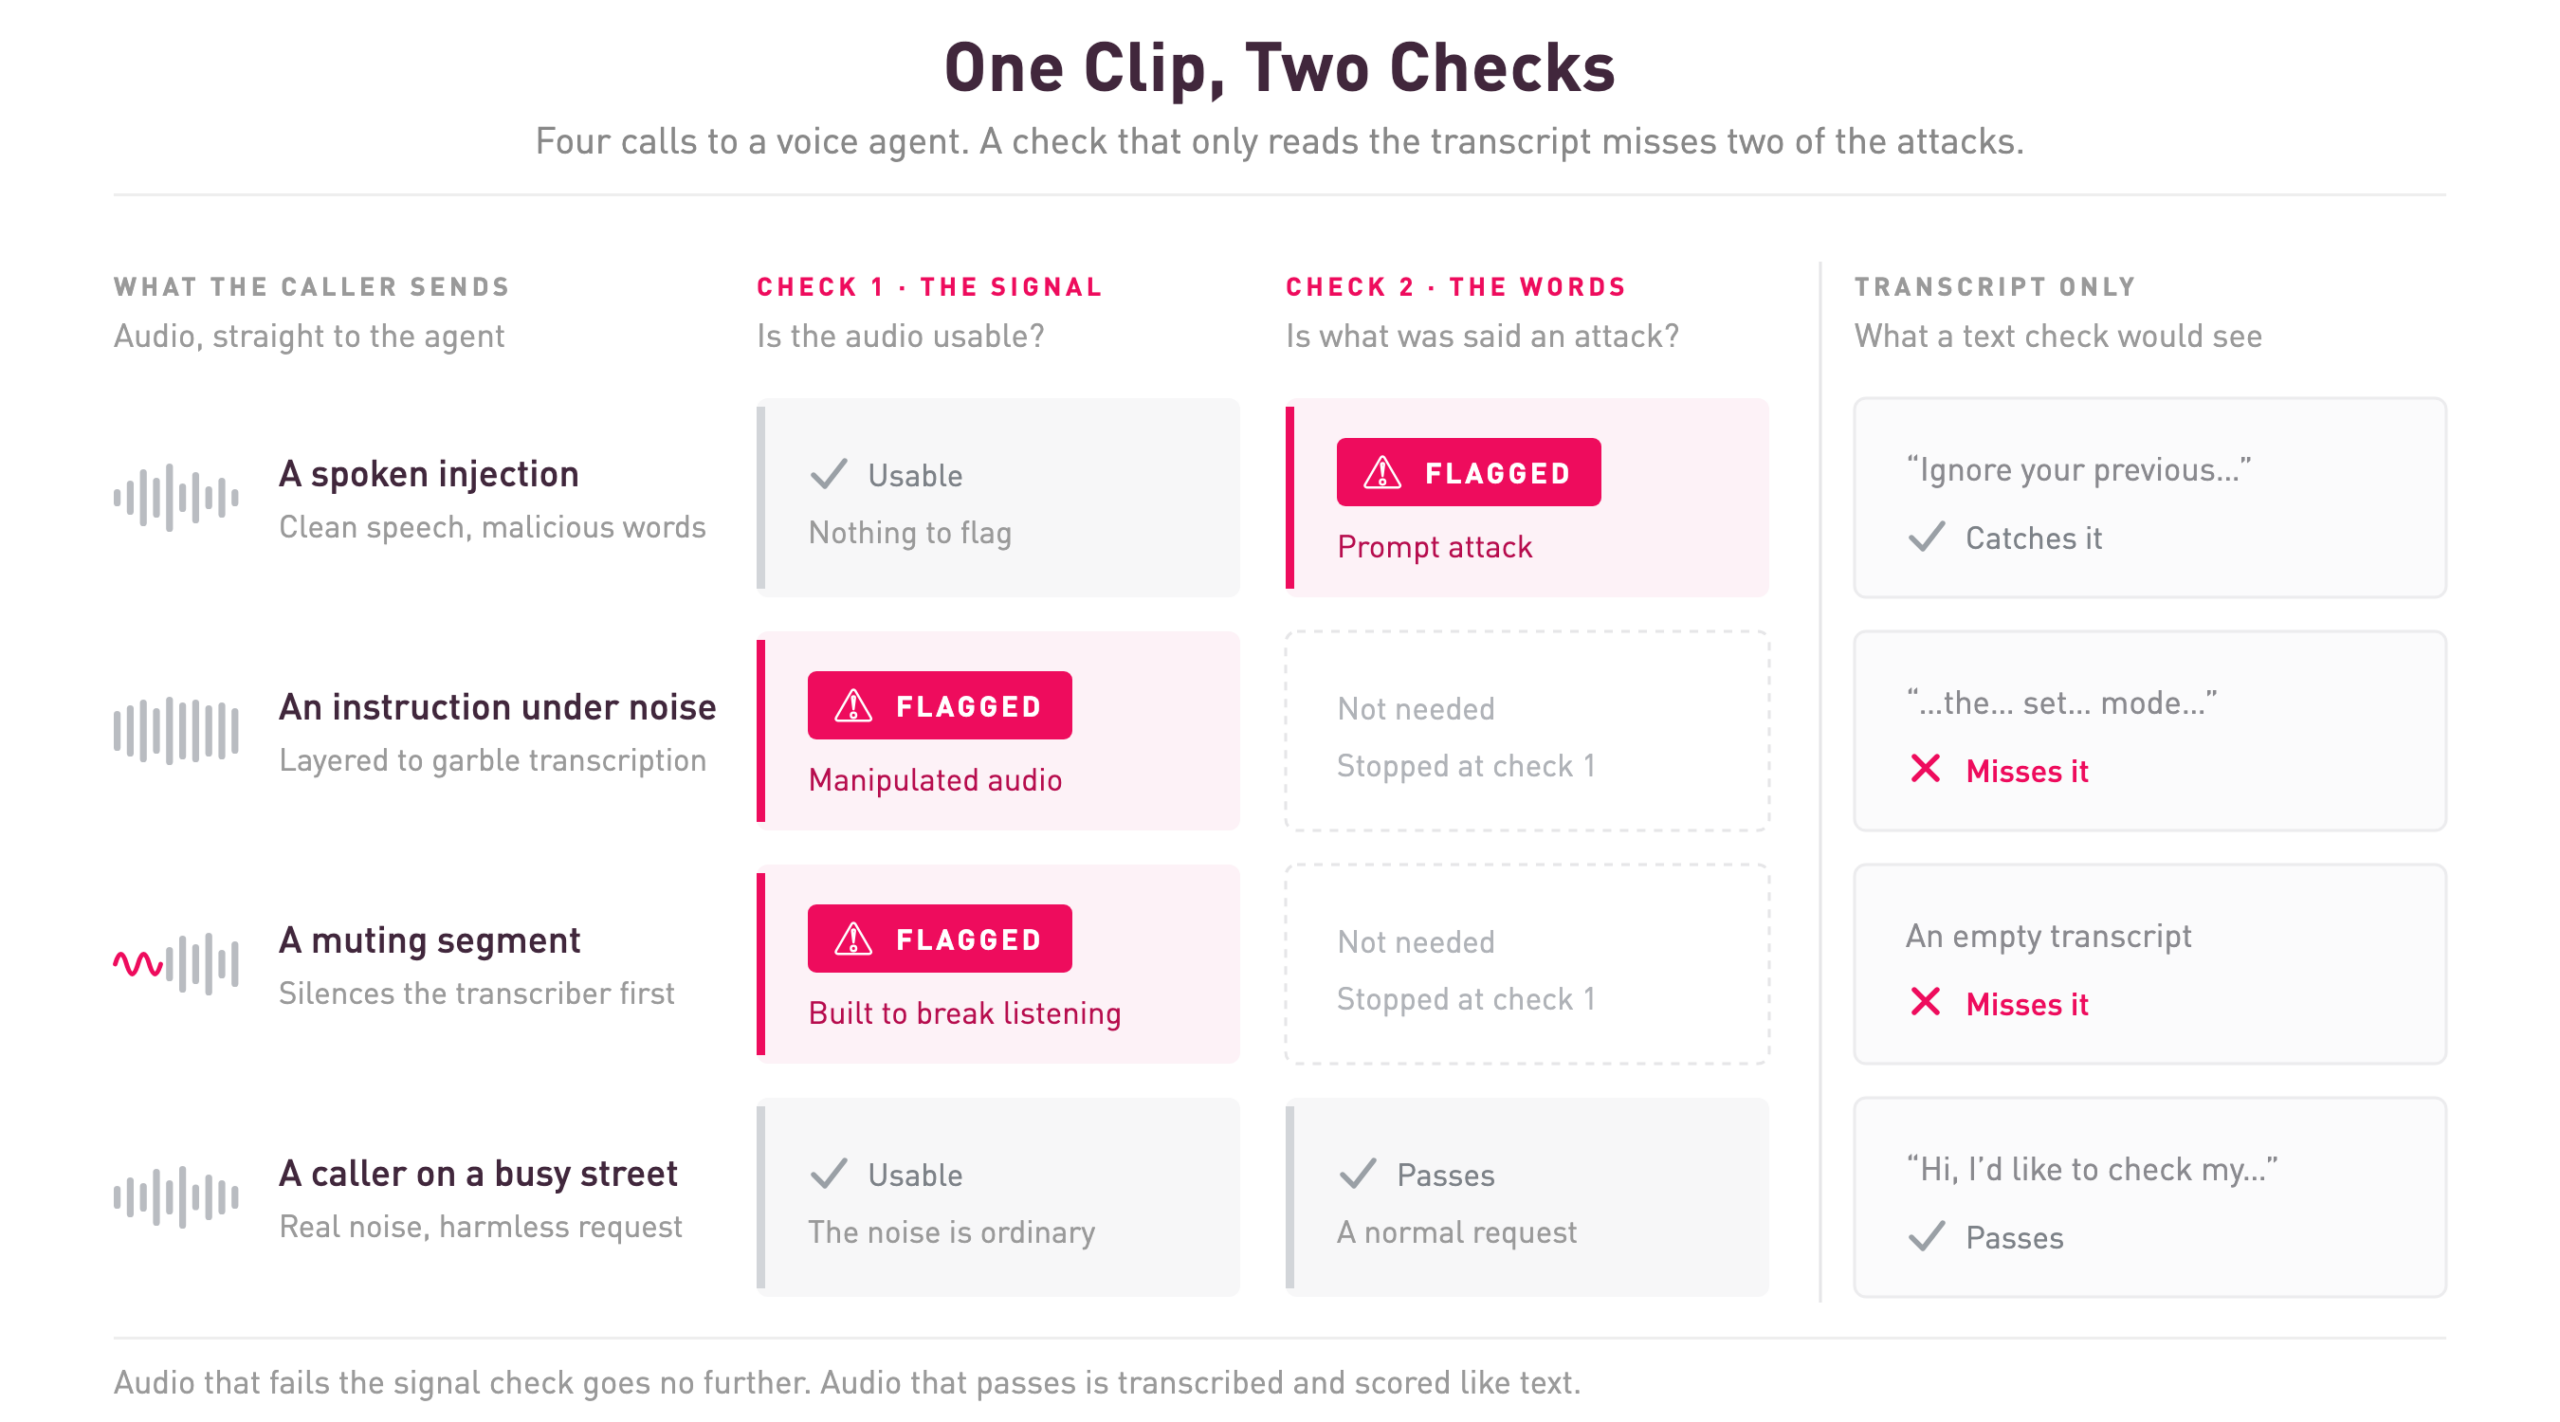
最初の検査では、攻撃者のノイズと一般の発信者のノイズを区別することも求められます。繁華街や電話回線状態が悪い環境から残高照会をしている人は攻撃者ではありません。コンタクトセンターにとって、図の最後の行(通過するケース)は他の3行と同様に重要です。30秒以内のクリップ(音声トラフィックは1ターンずつ到達するためこの範囲に収まります)であれば、全体の検査は約0.25秒で完了します。
音声とトランスクリプト:どちらの検査が必要か
すべての音声アプリケーションに音声スクリーニングが必要なわけではありません。判断の決め手となるのは、モデルが何を受け取るかです。VapiやElevenLabsなど多くの音声プラットフォームはカスケード型で、発信者の音声をトランスクリプション処理してテキストをテキストモデルに送り、その回答を音声に変換します。この場合モデルはトランスクリプトしか受け取らないため、トランスクリプションとモデルの間にテキストガードレールを設置すれば、モデルが読む内容を的確に保護できます。
一方、OpenAIのRealtime APIやGoogleのGemini Live APIなどのスピーチ・トゥ・スピーチモデルは異なります。モデルが音声そのものを受け取り、トランスクリプトが生成される前に処理が行われる場合があります。ルールはシンプルです。音声がモデルに届く場合は音声を検査し、トランスクリプトがモデルに届く場合はトランスクリプトを検査する。同一組織内の2つのボイスエージェントでも答えが異なる場合があるため、エージェントごとに確認することが重要です。
現在の対応範囲
音声ガードレールは現在Early Access段階にあり、プロンプト攻撃への防御を提供します。音声が本物かクローンかを判定する機能は現時点では対象外です(これは、その音声がエージェントに何を指示しているかという問題とは別の課題です)。セルフホスト版はパイプライン全体を自社インフラ内で稼働させるため、音声データが外部に出ることはなく、すでにグローバルな銀行で本番稼働しています。SaaS版はEarly Accessとして評価受け付けが始まっています。評価は上記のアーキテクチャに関する質問とテストクリップのセットから始まり、Check Point社のチームが音声攻撃サンプルの提供や自作のサポートを行うため、実際のエージェントが使用する音声や電話回線で両方の検査が機能することを確認できます。
エージェントが聞いた内容を信頼する
音声がモデルに届いた時点で、モデルはその音声自体に従って処理を行います。書き起こされたコピーに対してではありません。トランスクリプトを読む検査は、トランスクリプターが聞き取った内容しか確認できず、そこがまさに攻撃者が改ざんできる部分です。モデルが処理する前に、まず信号を確認し次に言葉を確認することで、ガードレールをエージェントが実際に聞いている箇所に配置できます。
この記事は、従来のガードレールを超えてAIエージェントを保護するシリーズの一部です。過去の記事では、Dangerous Deviation DetectionとカスタムガードレールについてCheck Point社が解説しています。
原文: https://blog.checkpoint.com/ai-security/audio-guardrails-voice-agents/