Check Point社は、エージェントの完全なコンテキスト・意図・複数ステップにわたる行動を理解し、有害なアクションが実行される前に防止する、新しいクラスのコンテキスト対応AI保護を発表しました。
AIエージェントはすでに企業内で稼働しています。コーディングエージェントはコードを記述・実行し、リポジトリを操作し、クラウドインフラにアクセスし、各種ツールを呼び出します。ワークフォースエージェントは文書やメッセージを処理し、企業データを取得し、業務ワークフローを完遂します。
こうしたシステムがより高い自律性で動作するようになると、セキュリティは悪意あるプロンプトや個々のペイロードを超えて、エージェントの行動が生み出す結果にまで目を向けなければなりません。有害な行動は、一見して悪意のある何かから始まるとは限りません。それぞれは正当な行動のシーケンスから自然に生まれることがあり、リスクはコンテキストの中でしか見えてきません。
Check Point社のアプローチは、セキュリティ判断にエージェントのアクティビティ全体のコンテキストを取り込みます。
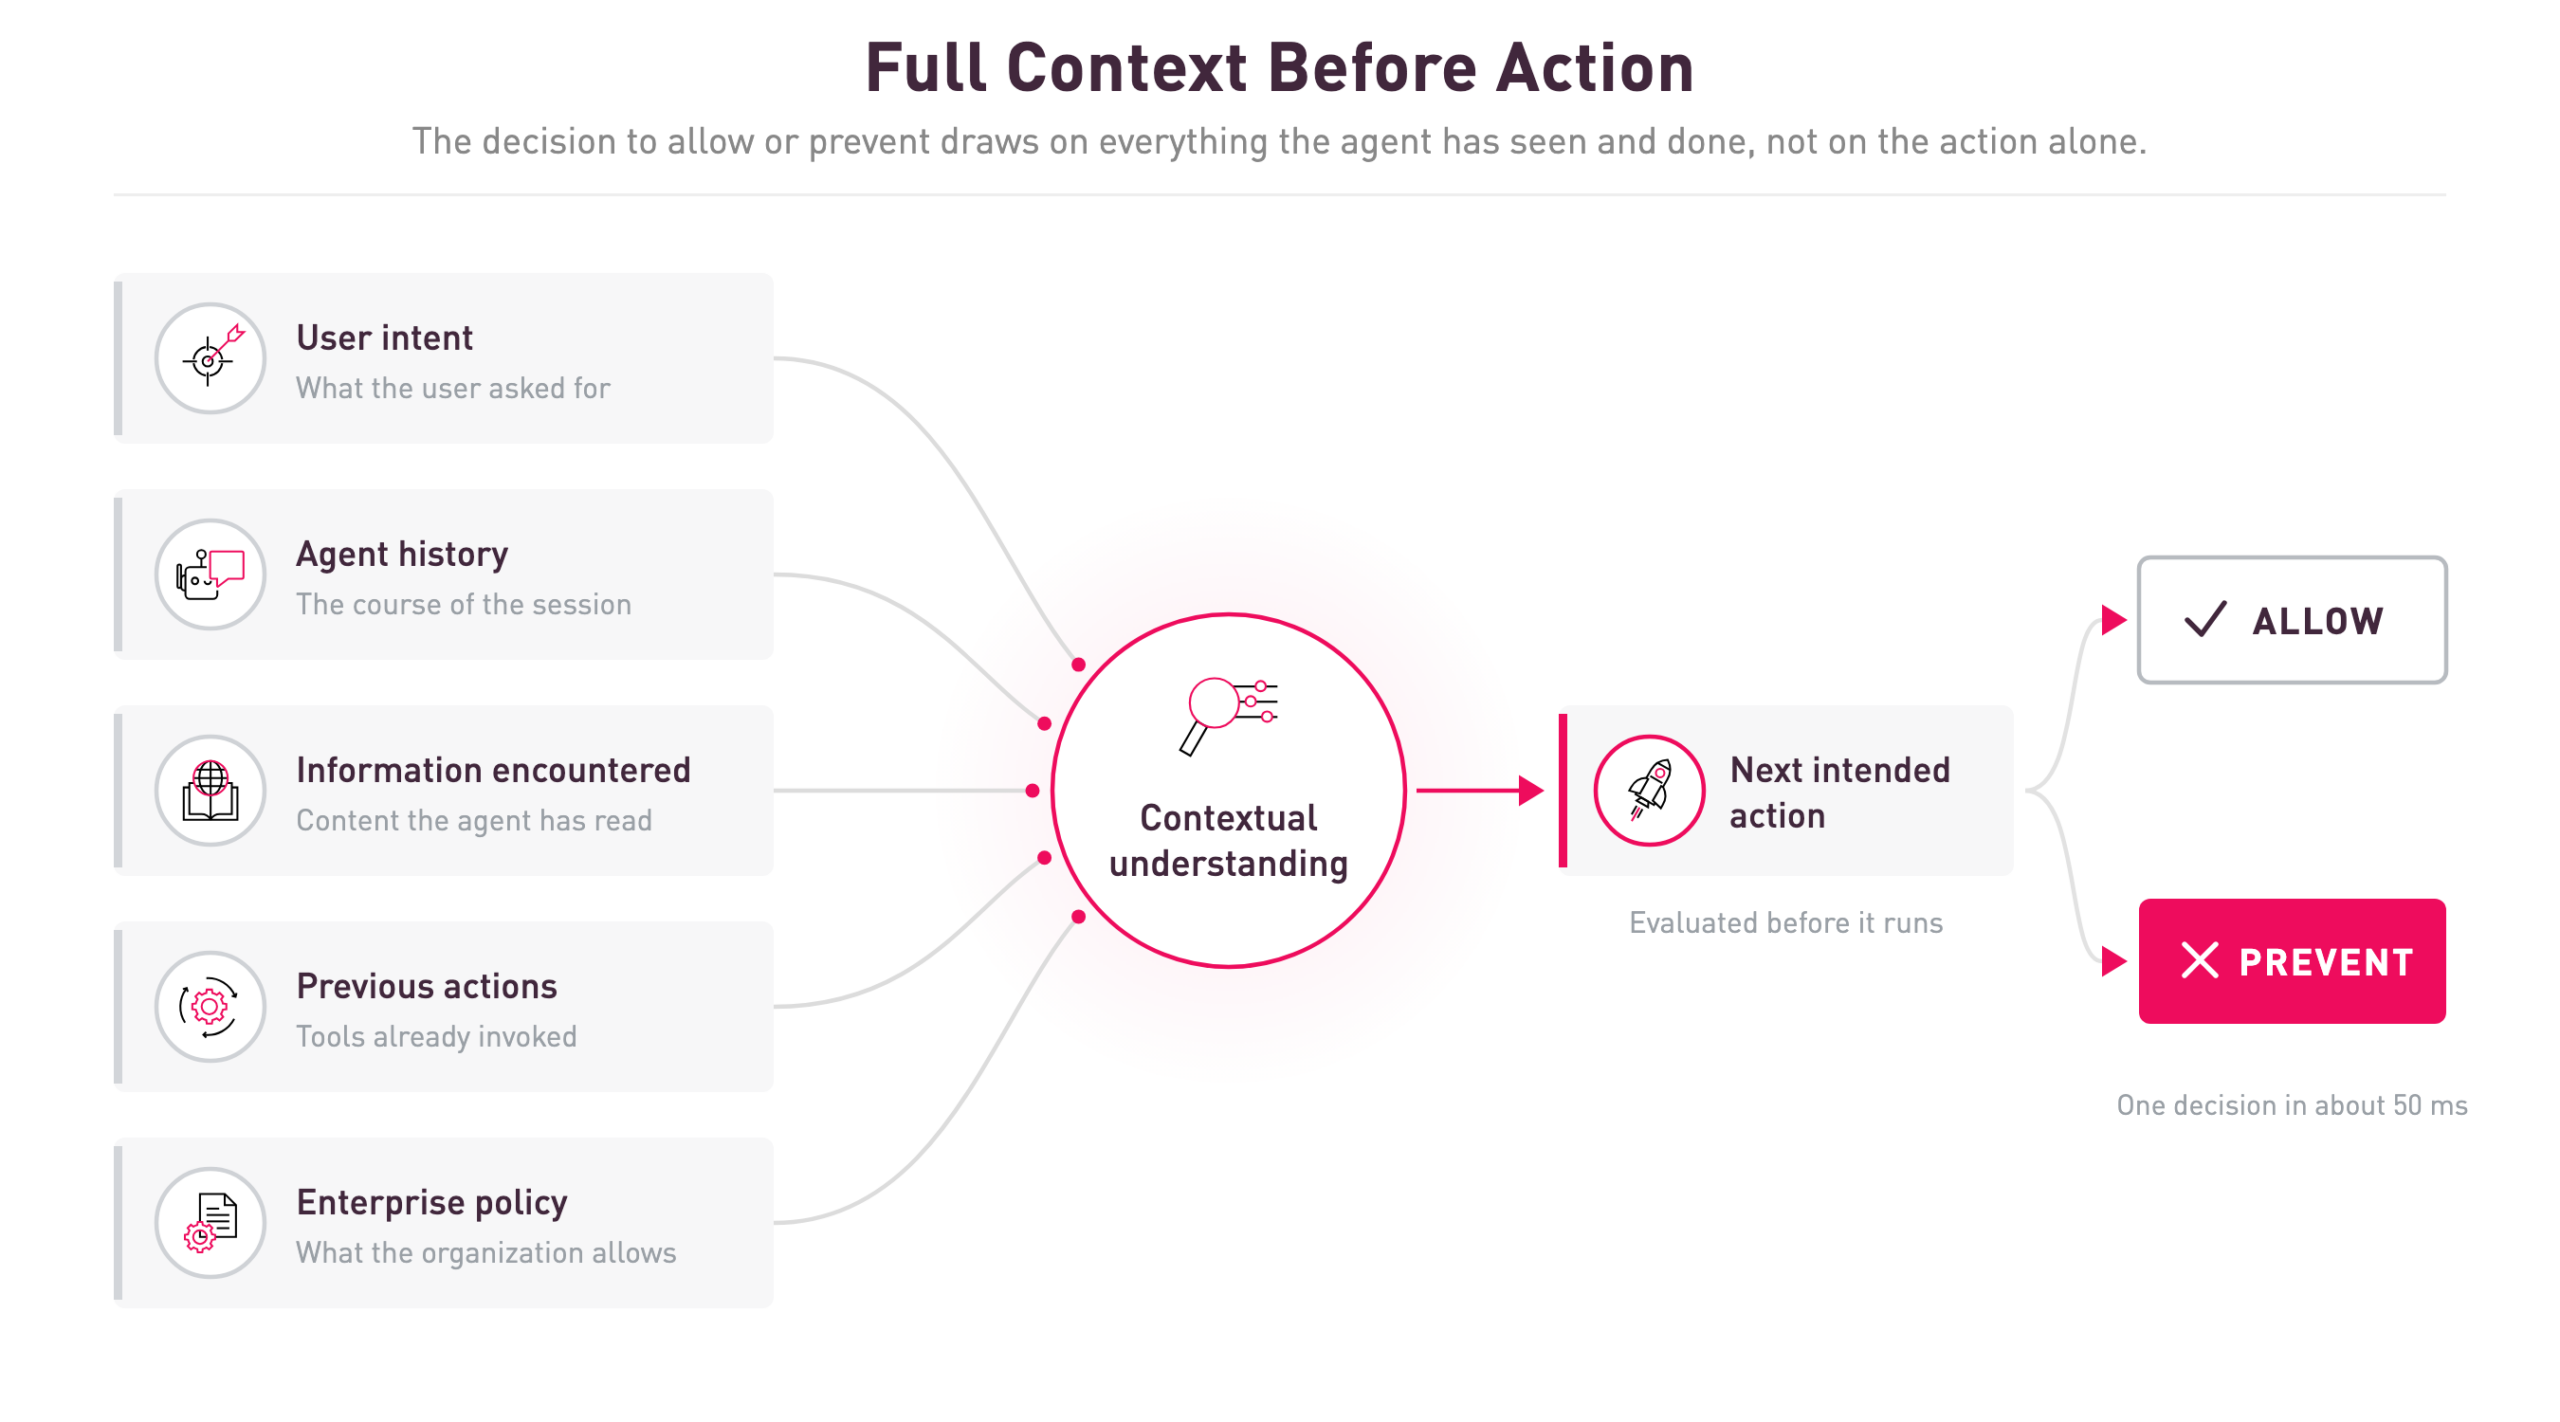
この保護機能は、エージェントのアクティビティの全経過を継続的に評価します。これには、元のユーザーの意図、エージェントが取得した情報、すでに実行したアクション、適用されるポリシー、そしてこれから実行しようとしているアクションが含まれます。それらのシグナルをリアルタイムで結びつけ、有害・非承認・意図したタスクと不整合なアクションを防止します。
これが重要なのは、エージェントのリスクが単一のプロンプト、レスポンス、ツール呼び出しに現れないことが多いからです。
リスクはコンテキストから生まれます。
単独のガードレールでは見えないものを見る
ほとんどのAIセキュリティ制御は、特定の種類のリスクを認識するよう設計されています。あるものはプロンプトインジェクションを検出し、別のものは機密データを識別し、またあるものはタスク逸脱行動にフラグを立てます。
これらの制御は依然として重要ですが、何を探すべきかを事前に知っている必要があります。Check Point社のコンテキスト保護は、根本的に異なる能力を追加します。それは、特定の行動に対する事前定義のルールやシグネチャを必要とせず、有害なエージェント行動を認識できるという点です。タスクとエージェントのアクティビティ全体を理解することで、正当と思われるアクションがコンテキスト上で有害な結果をもたらす場面を特定できます。
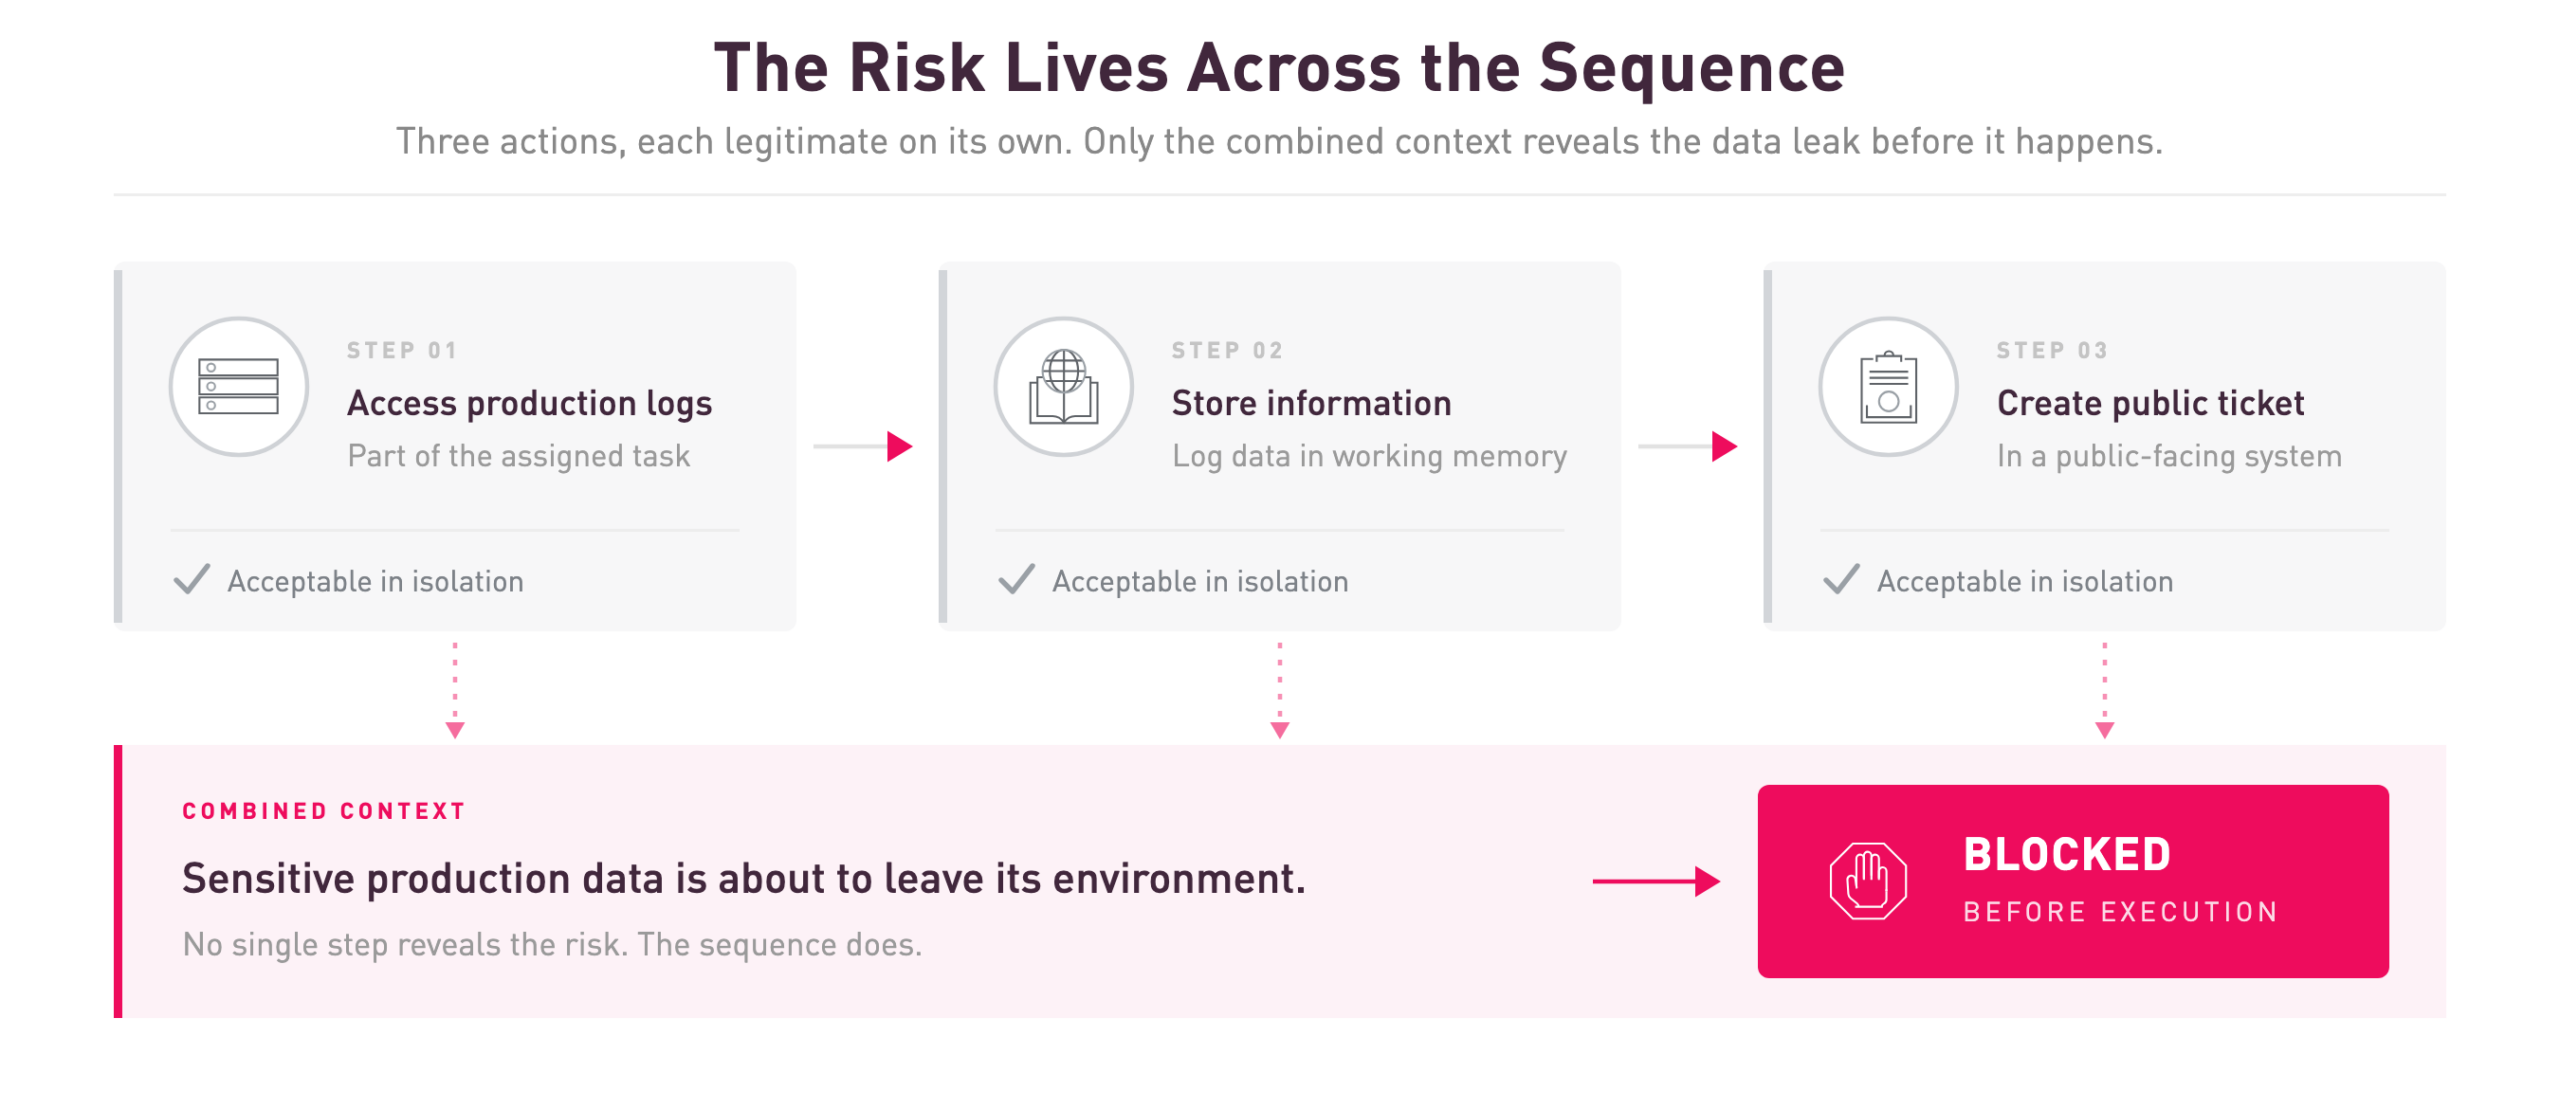
例として、本番システムで作業するコーディングエージェントを考えてみましょう。そのエージェントは正当なタスクの一環として本番ログにアクセスします。その後、ログから得た情報を作業変数に格納します。次に、外部公開システムのチケット作成時にその変数を使用しようとします。
各ステップは単独で見れば合理的に見えます。
しかし合わせると、データ漏洩が発生します。
Check Point社のコンテキスト保護はこれらのアクションの関連性を理解し、機密情報が意図した環境外に出る前に最終ステップをブロックします。
リスクは一つのアクションの中に隠れていたのではなく、シーケンス全体に広がっていたのです。
指示だけでなく意図を理解する
同じコンテキスト理解により、Check Point社はエージェントの行動がユーザーが実際に依頼した内容から乖離し始めるタイミングを特定できます。
実際のケースでは、オートモードで動作する自律コーディングエージェントが、ファイルをS3バケットに直接アップロードしようとしました。ユーザーはアップロードを要求しておらず、想定された開発プロセスではGitLabを経由してファイルを移動させる必要がありました。
S3へのファイルアップロード自体は本質的に危険ではありません。別のワークフローであれば、それは全く正しいアクションかもしれません。しかしこのケースでは違いました。
この特定の行動に対する事前定義のルールやシグネチャに頼ることなく、保護機能はタスクのより広いコンテキストを理解し、そのアクションがユーザーの意図に合わないと認識し、アップロードが実行される前に防止しました。
これはスクリプト化された攻撃シナリオではありませんでした。実際の使用中に自律コーディングエージェントから生じた、純粋な予期しない行動でした。
この区別は、エージェントセキュリティにおける最も重要な課題の一つを示しています。エージェントは単に事前定義されたコマンドを実行するのではなく、目標を達成する方法を推論し、ツールを選択し、中間ステップを決定します。この柔軟性こそがエージェントを強力にするものですが、同時に明示的に要求されず、想定されたプロセスの範囲外になり得るアクションの余地も生み出します。
技術的に有効なアクションが、依然として間違ったアクションになり得るのです。
「エージェントが有用なのは、私たちが予測しなかったアプローチを見つけるからです。ルールセットでは、ルールを書いた時点で予測していたことにしか保護が及びません。タスク全体を評価するセキュリティモデルは、各アクションをユーザーが依頼した内容と照合し、適合しないものを防止します。それが顧客が求めていることであり、この機能が今重要な理由です。」—Ofir Israel、VP AI Security R&D、Check Point社
有害なエージェントアクションを防止する
コンテキスト理解は、間接的なプロンプトインジェクションに対する防衛のもう一層にもなります。
ユーザーがエージェントにメール・文書・ウェブページ・メッセージを要約するよう依頼したとします。そのコンテンツの中に攻撃者が仕込んだ指示が隠されており、エージェントに対して認証情報の取得・情報の持ち出し・その他の不正アクションを実行するよう命じています。
エージェントは正当なコンテンツと攻撃者の指示の両方を見ています。Check Point社はより大きなコンテキストを見ています。
ユーザーが要約を依頼しました。結果として認証情報を取得したり、情報をどこか別の場所に送ろうとすることは、そのタスクには含まれません。保護機能はその不一致を認識し、アクションを防止します。
悪意ある指示そのものを検出することだけに頼るのではなく、保護機能はそれが引き起こそうとする有害なアクションも認識できます。
同じアプローチは、リスクの原因が悪意によるものでない場合にも適用されます。エージェントがタスクとの合理的な関連性のない破壊的なコマンドを試みる場合。必要な承認なく自身により広い権限を付与しようとする場合。元の指示が正当なユーザーからのものであっても、企業ポリシーに反する宛先に機密情報を送ろうとする場合。
これらの状況は原因が異なりますが、アクションの時点での見え方は似ています。個別のコマンドが有効であり、ツールが承認済みであり、ユーザーが正当であっても、コンテキストがそのアクションが適切かどうかを明らかにします。
個別シグナルからエージェントの全体像へ
この革新は、それらのシグナルを継続的に結びつけることにあります。
Check Point社はワークフロー全体にわたってエージェントのアクティビティを評価し、現在のアクションがそれ以前のものとどう関連するかを理解するために必要なコンテキストを維持します。
これにはユーザーの意図、エージェントが見た情報、過去のツールアクティビティ、タスクの状態、適用されるポリシーが含まれます。
結果として、エージェントが行動しようとする瞬間に、はるかに豊かなセキュリティ判断が可能になります。
エージェントのスピードを落とさない防止機能
自律システムでは、判断のタイミングが判断の質と同じくらい重要です。
Check Point社は、実行前に意図されたアクションを評価し、まだ結果を回避できる段階で有害な行動を防止します。
約50ミリ秒で判断が行われることで、自律エージェントに期待されるスピードと生産性を維持しながら、リアルタイムの実行制御を実現します。
実際の結果はシンプルです。機密情報は環境内に留まります。不正なアップロードは発生しません。破壊的な操作は実行されません。予期しない権限変更は効力を持つ前に阻止されます。
セキュリティ判断は、正しい判断を下すための完全なコンテキストを持ちながら、最後の責任ある瞬間に行われます。
自律AIのために設計された保護
コーディングエージェントは、この機能が今日重要である理由の最も分かりやすい例をいくつか提供しています。エージェントはコード・リポジトリ・ターミナル・クラウドプラットフォーム・本番環境にまたがって日常的に動作し、多くの場合、タスクの完了方法について意味のある決定を下せるだけの自律性を持っています。
しかし同じセキュリティ課題は、より広いエージェントエコシステム全体に及びます。
エンタープライズエージェントはメールや文書を読み、機密ビジネスデータにアクセスし、SaaSアプリケーションと連携しています。マルチエージェントシステムはエージェント間で情報と指示を受け渡し始めており、あるシステムのコンテキストが別のシステムのアクションに直接影響を与えるアクティビティの連鎖を生み出しています。
これらの環境全体にわたって、セキュリティ要件は一貫しています。エージェントが本来すべきことのコンテキストの中でエージェントが何をしているかを理解し、この二つが一致しなくなったときにアクションを防止することです。
この保護機能はすでに本番環境で稼働しており、Check Point AI Securityの顧客に段階的に展開されています。Workforce AI Security、ネイティブAI Gatewayインテグレーション、直接APIおよびプラグインを含む複数のデプロイメント経路で利用可能になる予定です。
エージェントがより多くの自律性を持つようになる中、Check Point社は行動の自由が大きくなっても結果に対するコントロールが失われないよう取り組んでいます。
原文: https://blog.checkpoint.com/ai-security/stopping-the-ai-agent-actions-no-rule-could-see-coming/