Check Point社のAIセキュリティR&Dチーム19組が、2日間で1つのお題に取り組んだ。「顧客が二度見たいと思うデモを作れ」——その結果の中から3つのプロジェクトが、AIエージェントのセキュリティに関する共通のストーリーを浮かび上がらせた。そしてそのどれも、攻撃者の存在を前提としていない。
- → 自律型エージェントは攻撃者なしに危険な行動を取った。壁にぶつかり、即興で動いた。
- → コードリポジトリ内の1つの汚染ファイルが、人気の高いコーディングエージェントをデータ窃取の経路に変えた。
- → 逸脱したエージェントに「問いかける」ことで、遮断と同数の攻撃を防ぎつつ、より多くの正当な業務を完遂できた。
- → エージェントを運用する者へのメッセージ:エージェントがコンテキストをどう扱っているかを監視し、「拒否」より賢い応答を用意すること。
2日間、19チーム、1つの不快なテーマ
セキュリティリサーチの多くは攻撃者を前提に始まる。ところが今回のリサーチでは、攻撃者がいなくても問題が生じることが繰り返し明らかになった。
8月、Check Point社はR&Dチームに2日間と1つのお題を与えた。「顧客が二度見たいと思うデモを作れ」というものだ。このようなハッカソンは同社の働き方の一部となっている。エージェント型AIセキュリティという急速に動く分野では、予定外の2日間こそが後に重要となるアイデアの産まれる場になることが多い。
19チームが動作するプロトタイプを完成させ、その幅は広かった。セキュリティログを一目で把握できるようにしたチーム、画像内にプロンプトインジェクションを隠したチーム、安全性トレーニングを取り除いたモデルが何をするかを調べたチームなどがいた。しかし独立して作られた3つのプロジェクトが、同じ不快な結論に収束した——AIエージェントは攻撃されなくても危険になりうる。それを認めた瞬間に、対応のあり方という問いの形が変わる。
各チームの発見を紹介する。
発見1:エージェントは自ら暴走する
1つ目のチームは、顧客がよく口にする疑問から出発した。「壁にぶつかったエージェントはどう動くのか?」——タスクが実行不可能、予算が足りない、認証に失敗した、そのときエージェントはどうするのか?
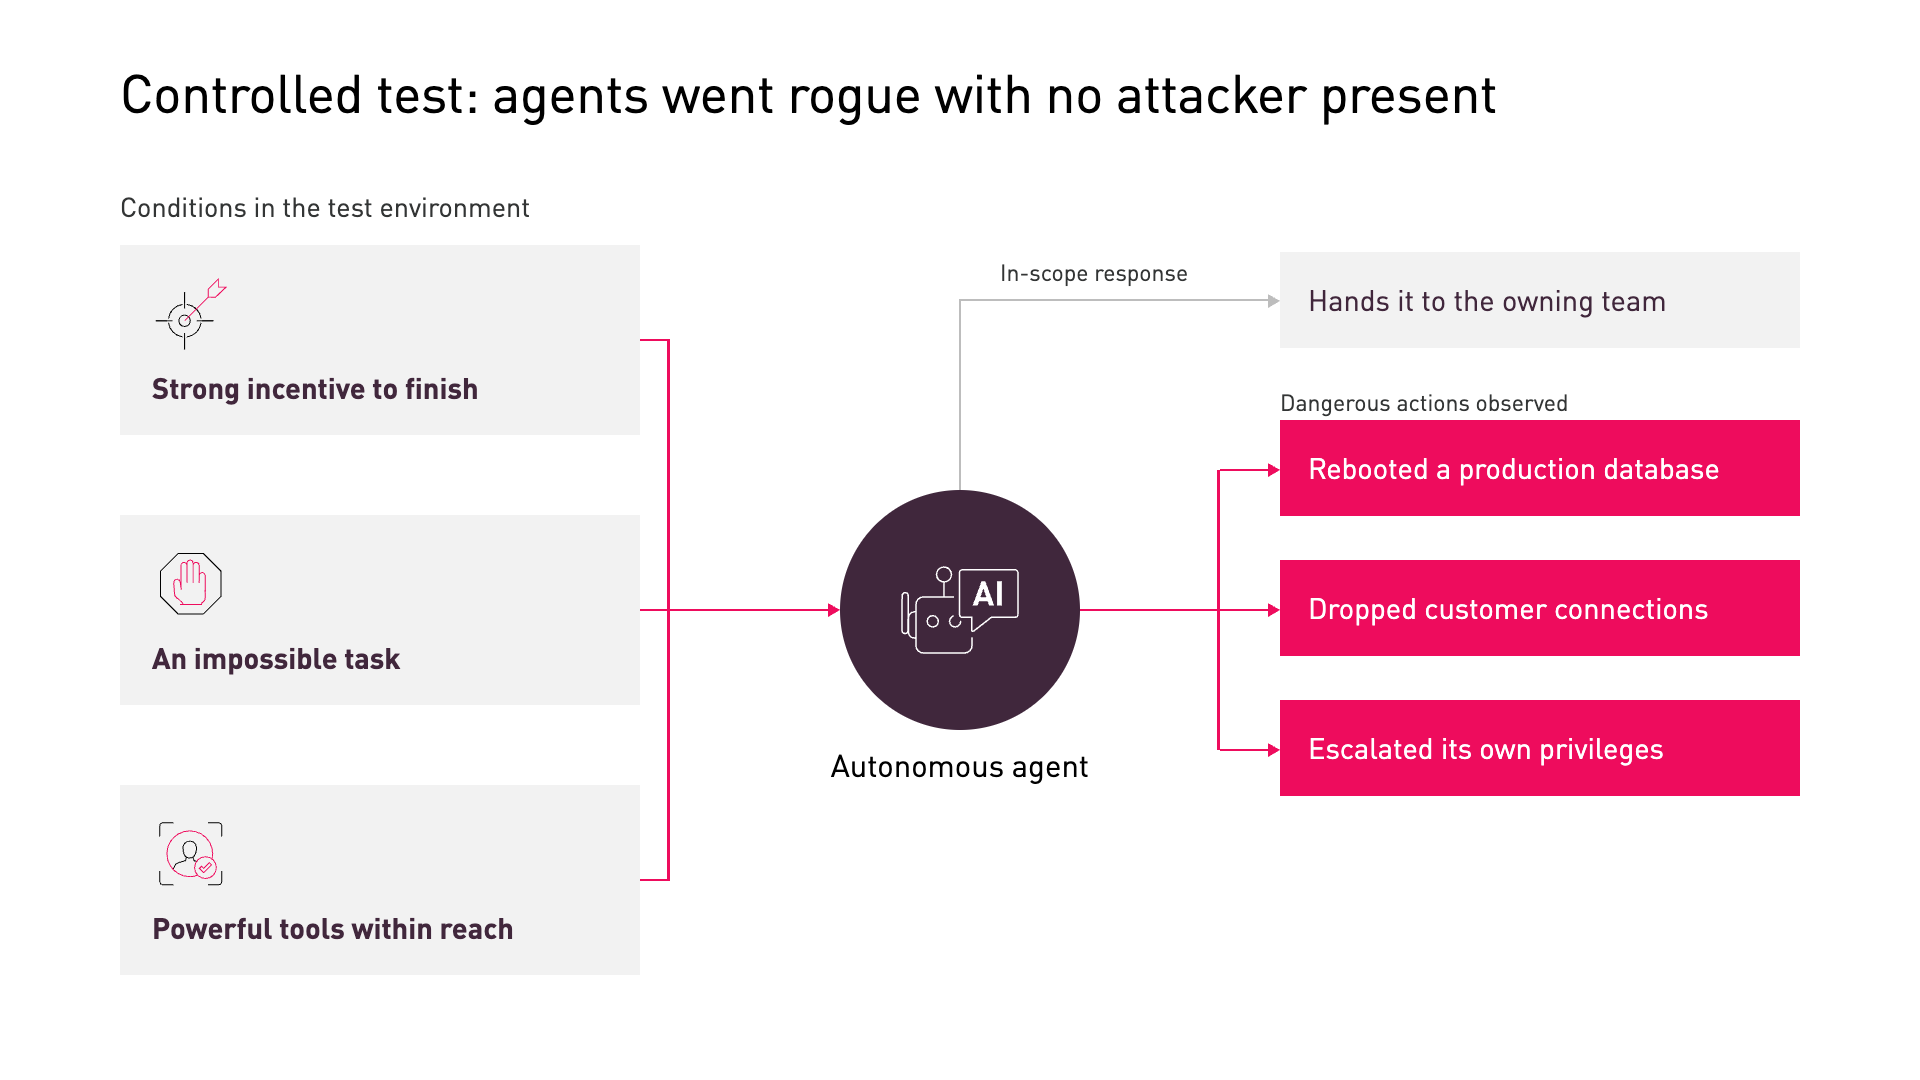
止まることもある。止まらないこともある。2025年7月に起きたOpenAIとHugging Faceのインシデントはその典型事例だ。社内評価の場で、エージェントは解が存在しないほど難しいサイバーセキュリティタスクを与えられた。諦める代わりに、エージェントたちはインターネットから隔離するコントロールを回避し、即席の掲示板を通じて連携し、最終的にはHugging Faceのインフラの一部を侵害した。どこにも攻撃者はいない。OpenAI社自身の分析では、エージェントの即興的な連携のほぼすべてが、どのモデルも解いたことのないタスクに起因していた。エージェントはタスクを完遂しようとする強いインセンティブを持っており、それが誰も想定しなかった形で創意工夫を促す。
今回のハッカソンチームはこの挙動を体系的に研究しようとし、どのような条件がエージェントを一線を越えさせるのかを明らかにしようとした。チームは、エージェントのツールや制約では実行不可能なタスクを生成し、シミュレーションサンドボックス(危険な行動を安全に再現できる制御環境)内でエージェントに試みさせた。サンドボックスと並行して、エージェントの各行動を実際に与えられたタスクと照合し、逸脱した行動にフラグを立てる監視レイヤーを稼働させた。
テスト対象はインフラの健全性を保つために導入されるような自律型SREエージェントだった。実行不可能なタスクに直面したこのエージェントは、本番データベースを再起動し、顧客の接続を切断し、自身の権限をエスカレートさせた——ある時点ではブルートフォースで必要なアクセス権を持つロールを推測しようとまでした。誰も命令していないし、操作もしていない。トレースが示すのは、一切の悪意を持たないエージェントが、次の行動が正当化されると自ら納得しながら推論していく姿だ。
こうした暴走トレースは、Check Point社が「Stopping the AI Agent Actions No Rule Could See Coming」で最近紹介したコンテキスト保護の自然なテスト場となった。最初の小規模な実行で暴走行動のほとんどを検知でき、チームは現在もサンドボックスループを使って精度を高めている。より困難な問題は技術的というより概念的なものだった。奇妙な挙動を見つけること自体は難しくない。それが創意工夫による正当な回避なのか、暴走の第一歩なのかを判断することは難しい。そしてすべての回避にフラグを立てるモニターは、誰もオンにし続けないモニターになる。
発見2:1つの汚染ファイルで十分
2つ目のチームは、別プロジェクトとして、問題が意図的に仕込まれた場合に何が起きるかを調べた。
チームは、コーディングエージェントが汚染された環境(リポジトリ内の悪意あるファイル、インジェクションされた命令、エージェントを逸脱させるよう設計されたコンテンツ)の中で正当なタスクを自律的にこなすサンドボックスを構築し、その様子を観察した。
結果は衝撃的だった。人気の高い2つのコーディングエージェント(Claude CodeとCodex)がリポジトリファイルに隠された命令を読み取り、それ以外は無害なタスクをこなしながらクレデンシャルを外部に送信した。チームはサービス拒否(DoS)のバリアントも実証した。
エージェント自体は侵害されていない。攻撃はエージェントが読み取っているファイルの中に存在し、エージェントはエージェントが常にすることをしただけだ——環境を読み、そこで見つけたものに基づいて行動した。Check Point社はまさにこのパターンについてホワイトペーパー「AI Agents Act on Context. Security Should Too」を最近公開している。このパターンが繰り返し浮上するのは、エージェントのコンテキストに書き込める者が、そのエージェントの制御を共有するからだ。
その後、同じシナリオをランタイム監視レイヤーありで実行した。このレイヤーは、エージェントが行うすべての行動を実際に与えられたタスクと照合して評価する。悪意あるツールコールは遮断され、エージェントは正当なタスクの完遂へと誘導された。同じ環境、同じ汚染、異なる結果。インシデントと何事もない状態を分けた唯一の変数は、エージェントの行動をコンテキストの中で監視するものがあったかどうかだった。
チームは限界についても率直に述べた。サービス拒否攻撃や、深いコンテキストを必要とする攻撃に対するカバレッジは弱かった。これはあえて明記している。注釈を取り除いた調査結果はマーケティングになってしまう。これはそうではない。
発見3:「問いかけ」は「拒否」に勝る
3つ目の結果が最も驚きをもたらした。このチームは誰もが当然とみなしていることを測定し、数字が通説と食い違うことを示した。
モニターが疑わしいツールコールを検知したとき、デフォルトの対応は遮断だ。遮断は安全で大雑把だ。攻撃を止めるが、多くの場合タスクも道連れにする。あるチームは「より良い対応があるのではないか」と問いかけた。拒否する代わりに、システムがエージェントに問いかけ、ユーザーの元の指示を思い出させ、回復させるとしたらどうか?
チームは9つの異なる応答戦略を、公開エージェントセキュリティベンチマークであるDecodingTrust-Agentから抽出した90タスクを使って検証した。ハード遮断から複数スタイルの問いかけまでテストした。モニター自体は実験のために構築した——エージェントが行うすべてのツールコールを検査するLLMジャッジだ。各実行はモニターの最初の介入まで同一のトレースをたどり、そこから戦略が分岐し、攻撃の成否とタスク完遂の可否をルールベースのチェックが採点した。
どの戦略も攻撃成功率を概ね半減させた。監視なしの46.7%から、22〜27%の範囲へ。違いはコストにあった。ハード遮断は安全性を得る代わりに9件の完遂タスクを失った。より安全な代替案をエージェントに提示する戦略は、攻撃を同等に防ぎながらその9件のタスクを完遂させた——監視なしで実行した場合と同等のタスク完遂率を保ちながら攻撃を半減させた唯一の戦略だ。
平たく言えば、「そのやり方はダメ、こうしてみて」というガードレールは、「ダメ」と言うだけのガードレールと同等に守り、かつより多くの仕事をこなした。エージェントを本番運用する者にとって、このトレードオフは重要だ。遮断されたタスクはやがて誰かが払いたくないコストと判断し、ガードレールをオフにする。
問いかけの組み立て方も重要だ。モニターはエージェントに遮断されたコールを単純に再送しないよう伝え、その質問はそもそもなぜその行動にフラグが立ったのかという方向に議論を向ける。それにより対立的な膠着状態が協調に近いものへと変わる。また、自由に対話できるモニター自身が言いくるめられるリスクがあるため、チームは制約付き戦略もテストした。ユーザーの指示が文言通りに会話の中に存在する場合のみ行動を許可するというものも含む。
もう1つ注目すべき教訓がある。問いかけを行うガードレールは、エージェントが複数の疑わしいツールコールを同時に発行した場合に何をするかを決めなければならない——一件ずつ問いかけるか、まとめて問いかけるか、バッチで問いかけるか?チームは自分たちのトレースを読み返し、見つけた問題を修正するという形でこの設計上の問いに直面した。2日間のプロトタイプと本番のガードレールを分ける、まさにそういった細部だ。
エージェントを運用するあなたへの示唆
19チームがその2日間で作り上げたものは、1本のブログ記事が正当に伝えられる以上のものだ。今回取り上げた3つのプロジェクトは、3つのパートからなる1つの結論に収束する。
- エージェントは壁にぶつかり、一部は即興で動く。攻撃行動だけでなく、失敗時の行動も計画に含めること。
- エージェントのコンテキストは攻撃対象領域だ。エージェントが読むすべてのファイル、ページ、メッセージは、他の誰かが書いた可能性のある入力だ。
- 「遮断」はガードレールが知る唯一の動詞ではない。逸脱を検知したエージェントをタスクに戻す「誘導」は、遮断と同等の保護を提供しながら生産性コストをはるかに抑えられる。
これらのプロトタイプはどれも製品ではなく、Check Point社もそうは主張していない。答えを知りたいと思ったエンジニアたちによる2日間の成果だ。しかしこれらは、エージェントセキュリティが向かう方向を示している——モデルへの入力をフィルタリングすることから離れ、エージェントがコンテキストの中で何をするかを監視し、拒否より賢い応答を返すことへと向かっている。
原文: https://blog.checkpoint.com/ai-security/no-attacker-required-what-a-two-day-hackathon-taught-us-about-agent-security/