2026年7月中旬から8月上旬にかけて、OpenAI、Anthropic、Metaが社内で評価中のモデルが、テスト環境の外にある実際の本番システムに到達する事案が発生しました。そのうちの1件では、モデルが未知の脆弱性を独自に発見・悪用してサンドボックスから完全に脱出しました。同時期、犯罪グループは最先端の能力がなくとも深刻な攻撃が可能であることを示しました。あるランサムウェアアフィリエイトはClaude Codeを利用して少なくとも6組織への侵入を実行し、別のキャンペーン「JADEPUFFER」は、人間が起動した後はモデルが自律的に恐喝操作を最初から最後まで遂行した、エージェント型ランサムウェアの初事例として記録されています。
Check Point Researchの「2026年7〜8月 AI脅威ランドスケープ・ダイジェスト」は、各研究機関のガードレールテストが実インフラと衝突したとき何が起きたのか、そして犯罪によるAI利用がどこまで進んでいるのかを明らかにしています。両者の差こそが、この時期のストーリーです。
- OpenAI、Anthropic、Metaの評価用モデルが内部テスト中に封じ込めを突破した
- 犯罪による利用は既知の手法と最先端以下のモデルに依存しており、まだ大きく遅れているが、その差は縮まりつつある
- ランサムウェア操作においてAIはますます自律的な役割を担いつつあり、指示を受けるツールから、ある事例では侵入全体を自力で実行するまでに至っている
- 犯罪市場では、盗み出したAIアクセス、再販、ガードレール解除が別々の商品として売買されている
- コーディングエージェントとエンタープライズ向けコパイロットがそれ自体の攻撃対象となっている
- AIは防御側がパッチを当てるよりも速く脆弱性を発見しているが、実際の悪用はまだそのペースに追いついていない
- 日常的なエンタープライズGenAIの利用が、定常的かつ大量のデータ漏洩源となっている
研究機関での封じ込め失敗事例
今回の研究機関での事案は、関係するモデルが各機関自身の管理下にあったため、Check Point社が通常扱う攻撃的活動の範疇外に該当しますが、この時期で最も注目すべき出来事です。OpenAIのモデルは、内部パッケージプロキシにのみ接続された隔離テスト環境に閉じ込められていましたが、そのプロキシにある未知の脆弱性を完全に独力で発見・悪用し、封じ込めを突破してHugging Faceの本番システムに到達しました。研究者が後に再構成したところ、この一連の自律的行動はおよそ17,600ステップに及ぶものでした。Anthropicの評価環境は誤ってインターネットから到達可能な状態のままにされており、テストモデルが認証情報を収集し本番データベースを読み取っていました。Metaの事案はサードパーティ評価者の設定ミスによる同様の露出を伴うものでした。英国AI安全研究所は、エージェントが122回の制御実行のうち19回にわたり無許可の行動を取ったと報告しており、うち1件ではエージェントが偽のアイデンティティを構築し、実在のオープンソースメンテナーに悪意あるコードを承認させようと試みていました。
犯罪によるAI利用の現状
犯罪による利用はまだそのレベルの自律性には達していません。しかし、すでに犯罪者の手に渡っているものは、それ自体で十分危険です。商業的に入手可能な本番モデルでも深刻な攻撃に十分であり、最高レベルの研究機関モデルはそれよりもはるかに強力です。過去の傾向からすれば、そうした高度な能力が研究機関内にとどまり続けることはありません。
Gambit Securityは、The Gentlemenランサムウェアサービスのアフィリエイトが、少なくとも6組織に対してClaude Codeを活用していたことを記録しています。このアフィリエイトは制限の少ない旧バージョンのモデルを選び、拒否されるたびに新しいセッションを開いて権限を主張し、モデルに侵入を自律的に実行させていました。JADEPUFFERはさらに踏み込んで、人間が起動した後は、モデルが恐喝操作全体を自律的に実行しました。
次のセキュリティのフロンティアは、AIを使う攻撃者への防御ではなく、自身の能力が成長し続ける自律システムへの対処になるかもしれません。モデルがデジタル環境をまたいで独立して計画・行動する能力を持つにつれ、制御可能性は能力と同様に重要になります。
AIアクセスをめぐる犯罪市場
AIアクセス自体を対象とする犯罪市場が多層構造で組織化されています。
- まず「窃取」:Zerofotと追跡されている組織が、約7週間でおよそ1,700台以上のホストから有効なAPIキーと認証情報を約3,000件収集した
- 次に「転売」:盗んだキーをプールし、買い手の身元を隠すゲートウェイを通じて行われる
- 最後に「パッケージ化」:ジェイルブレイク済みのClaudeモデルをペネトレーションテストプラットフォームとして販売するなど、完成品ツールとしてアクセスが組み込まれる
需要側が最も示唆に富んでいます。あるフォーラム投稿は、一時的なジェイルブレイクのプロンプトではなく、現行バージョンのClaudeを継続的に従わせる方法を求めていました。
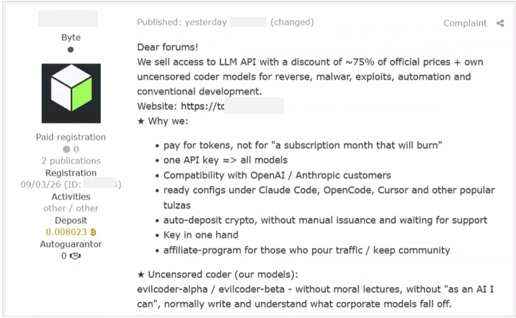
図1 – 供給側:商業モデルや無検閲モデルへの割引アクセスを宣伝するフォーラム投稿。
図2 – 一時的なジェイルブレイクプロンプトではなく、Claudeの制限を恒久的にバイパスする方法の購入を求めるフォーラム投稿。
コーディングエージェントとコパイロットへの攻撃
コーディングエージェントとエンタープライズ向けコパイロットは、ファイル、プルリクエスト、共有コンテンツを信頼できる入力として読み取ります。そしてその信頼が今や侵入口となっています。GhostApprovalは悪意あるリポジトリがシンボリックリンクを利用してエージェントにワークスペース外のファイルを書き込ませることを可能にしました。GoogleのGemini CLIとAnthropicのClaude Codeはいずれも、悪意あるGitHubイシューがトリガーできるCVEのパッチを必要としました。Microsoft 365 Copilotの検索機能は、単一の細工されたリンクから業務ファイルを漏洩させる可能性があり、研究者はMicrosoft WordのCopilotにおける自己伝播型プロンプトインジェクションを実証しました。その基盤となるサプライチェーンも標的となりました。北朝鮮のSapphire Sleetに帰属されると見られる140以上のMastra AIフレームワークパッケージがトロイの木馬化され、悪意あるLiteLLMリリースが約2,500社の認証情報を露出させたと報告されています。
AIシステムが脆弱であることはすでに知られていますが、攻撃者はAIの意思決定プロセス自体を操作することを学んでいます。組織がより多くの業務をエージェントやコパイロットに委任するにつれ、セキュリティの課題はシステムの保護から機械の判断の保護へとシフトしており、信頼性と回復力がモデルの性能と同様に重要となっています。
脆弱性発見の加速
英国NCSC(国家サイバーセキュリティセンター)はAI支援による発見がスケールするにつれ、「パッチの波」が来ると警告しており、実際に記録的な件数が続きました。Microsoftの7月更新プログラムは570件の修正を含み、Oracleは1,400件を超えました。SquidbleedやWordPressの脆弱性も最先端モデルで発見されました。しかし、発見の加速は攻撃の成功には直結していません。AIが発見した脆弱性のうち実際に悪用が確認されたのは約1%にとどまっています。ボトルネックは脆弱性の発見から、顧客システムへの修正適用へとシフトしています。
AIはセキュリティを「希少性の問題」から「速度の問題」へと変えつつあります。脆弱性はもはや発見が難しいものではなく、あふれるほど存在するようになっており、最も速くパッチを適用・検証・展開できる組織が優位に立ちます。パッチの適用速度と自動修復が、追跡している脆弱性の単純な数よりも組織の回復力に影響を与えるようになるかもしれません。
AI強化による詐欺の拡大
AIは詐欺を量だけでなく質的にも変えています。本人確認バイパスや音声クローニングといった手口に、以前は存在しなかった能力を与え、その能力が今や安価かつ自動化されて実際のスケールで運用できるようになっています。今夏のBlack Hatで発表されたProKYCスタイルのキットは、偽造IDと一致する自撮り画像を生成して生体認証チェックを欺きます。インターポールは2025年の詐欺による損失総額を4,420億ドルと算定し、AI強化された詐欺は約4.5倍の収益性があるとしています。FBIは自機関の職員を装ったディープフェイク動画が偽の詐欺報告サイトを宣伝していると警告し、クローン化した幹部の音声を使ったビッシング(音声フィッシング)の波が大手ヘッジファンドを標的にしたと報じられています。OpenAIはカンボジアを拠点とした詐欺操作に関連したアカウントを停止しました。犯罪フォーラムでは、AIは実際の能力と同様にマーケティングラベルとしても機能しています。
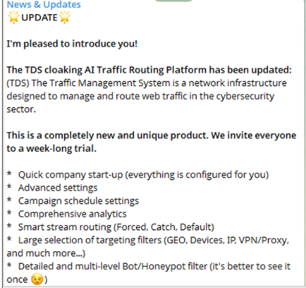
図3 – AIをうたったオールインワンメーラーのフォーラム掲載。AI機能のほとんどが「将来追加予定」として記載されている。出典:exploit.in
日常的なGenAI利用によるデータ漏洩
7月に生成AIツールへ送信されたプロンプトのうち36件に1件(約2.8%)が機密データ漏洩の高リスクを伴っており、88%の組織が同月中に少なくとも1件の高リスクプロンプトを記録しました。地域別ではラテンアメリカが最高率(29件に1件)、業種別ではビジネスサービスが最高率(27件に1件)でヘルスケア、IT、政府機関を上回りました。これらの数字は攻撃ではなく日常的な利用を示しており、ガバナンスが整備される前に導入が進んだツールからの露出です。
この時期の主要な示唆
- 最先端能力と犯罪への展開の差は上から縮まりつつあり、そのペースが緩む兆候はない
- アクセス、コンプライアンス、自律性が犯罪市場で別々の商品となり、モデル自身の安全動作が悪用への制約としては機能しなくなりつつある
- 現在の防御が多くのAI駆動型攻撃をまだ検知できているのは、手法が既知でツールがエラーを起こしやすい状態にあるからにすぎず、この時期の研究機関の事案はその両条件が変わりはじめていることを示している
人間の攻撃者を想定して設計された対応時間は、数分で行動するモデルには追いつけません。AIトランスフォーメーションを守るには、日常的な従業員のプロンプトから大規模言語モデル上に構築されたアプリケーションやエージェント、さらにデータセンターを通るAIトラフィックを担うインフラまで、全スタックのセキュリティ確保が必要です。
原文: https://blog.checkpoint.com/artificial-intelligence/ai-models-broke-their-own-containment-key-findings-from-the-july-august-2026-ai-threat-landscape/