主なポイント
Check Point社の「2026年クラウドセキュリティレポート」によると、過去1年間に78%の組織がAI関連のセキュリティインシデント(確認済みまたは疑いあり)を報告しています。
- 攻撃者は不要。エージェントは自ら手順を計画するため、支援しようとしたエージェントが誰も依頼していない行動(データ削除・漏えい・アクセス権の拡大)を取ることがあります。
- 権限設定とプロンプト監査は「行動そのもの」を見ていません。最小権限の原則は業務に必要なアクセスを取り除けず、プロンプト攻撃検知はエージェントへの入力を検査するだけで、エージェントがこれから何をしようとしているかはチェックしません。
- Dangerous Deviation Detectionは各ツール呼び出しを実行前に確認します。呼び出しが危険であり、かつユーザーやシステムが要求したものでない場合にのみフラグを立てます。メール・ファイル・Webページに隠された指示は一切「承認」とみなされません。
だからこそ、エージェントが行う各アクションは実行前に個別のチェックが必要です。エージェントに何が伝えられたかだけでなく、エージェントがこれから何をしようとしているかを確認する必要があります。Check Point AI Securityがどのようにエージェントを保護するかをご覧ください。
役に立とうとしたエージェントがタスクを逸脱するまで
逸脱のほとんどは、エージェントが支援しようとするところから始まります。タスクが曖昧だったり、明確な経路が塞がれていたり、途中で読んだ内容が別の方向を示していたりすると、エージェントは別のルートを即興で考え出します。リスクは、実際に展開する価値のあるエージェントこそが被害をもたらし得るという点にあります。CRMを管理したり、コードベースを保守したり、顧客メールに対応するエージェントは、書き込み・削除・送信の権限を持つ必要があるため、その場で考え出した手順も同様の操作になり得ます。
2025年7月、あるAIコーディングエージェントが明示的なコードフリーズ期間中に本番データベースを削除しました。同月、OpenAI社は内部評価において、既知の解決策のないタスクを与えられたエージェントが隔離環境を回避し、Hugging Faceの本番インフラの一部に到達したと報告しました。Check Point社が8月に開催した2日間のハッカソンでは、不可能なタスクに直面したSREエージェントが本番データベースを再起動し、自身の権限を昇格させました。これらのケースでは誰もエージェントを攻撃しておらず、それぞれのエージェントは支援しようとしていたのです。
権限管理とプロンプト攻撃検知の限界
最小権限とプロンプト攻撃検知は、多くのチームが最初に手を伸ばす対策であり、どちらも不可欠です。しかし、どちらも「行動そのもの」を見ていません。最小権限は、業務がリスクの両面を必要とする場合に限界を迎えます。サポートエージェントは顧客情報とメールシステムの両方へのアクセスが必要であり、どちらかを取り除けば機能しなくなります。プロンプト攻撃検知はエージェントへの入力を検査し、モデルが実行に移す前に操作を防ぎます。ただし、これは攻撃者を想定した仕組みであり、上述のインシデントには攻撃者が存在しませんでした。そのため、エージェントに何が伝えられたかだけでなく、エージェントがこれから何をしようとしているかを問う必要があります。
アクション実行直前の1つの問い
Dangerous Deviation Detectionは、モデルがツール呼び出しを選択した後、ツールが実際に実行される前という「決定が行動に変わる瞬間」に位置します。そこで1つの問いを投げかけます。
「この特定の引数を持つこの特定の呼び出しは、誰も求めていない危険な操作ではないか?」
エージェントがそこに至った経緯が操作・幻覚・単純な行き過ぎのどれであるかは問いません。チェックされるのは結果として生じた呼び出しです。検知器は、ユーザーが依頼した内容・システム指示が許可する範囲・エージェントが持つツールというタスクの文脈の中でその呼び出しを評価します。
「危険かつ承認なし」のみフラグを立てる
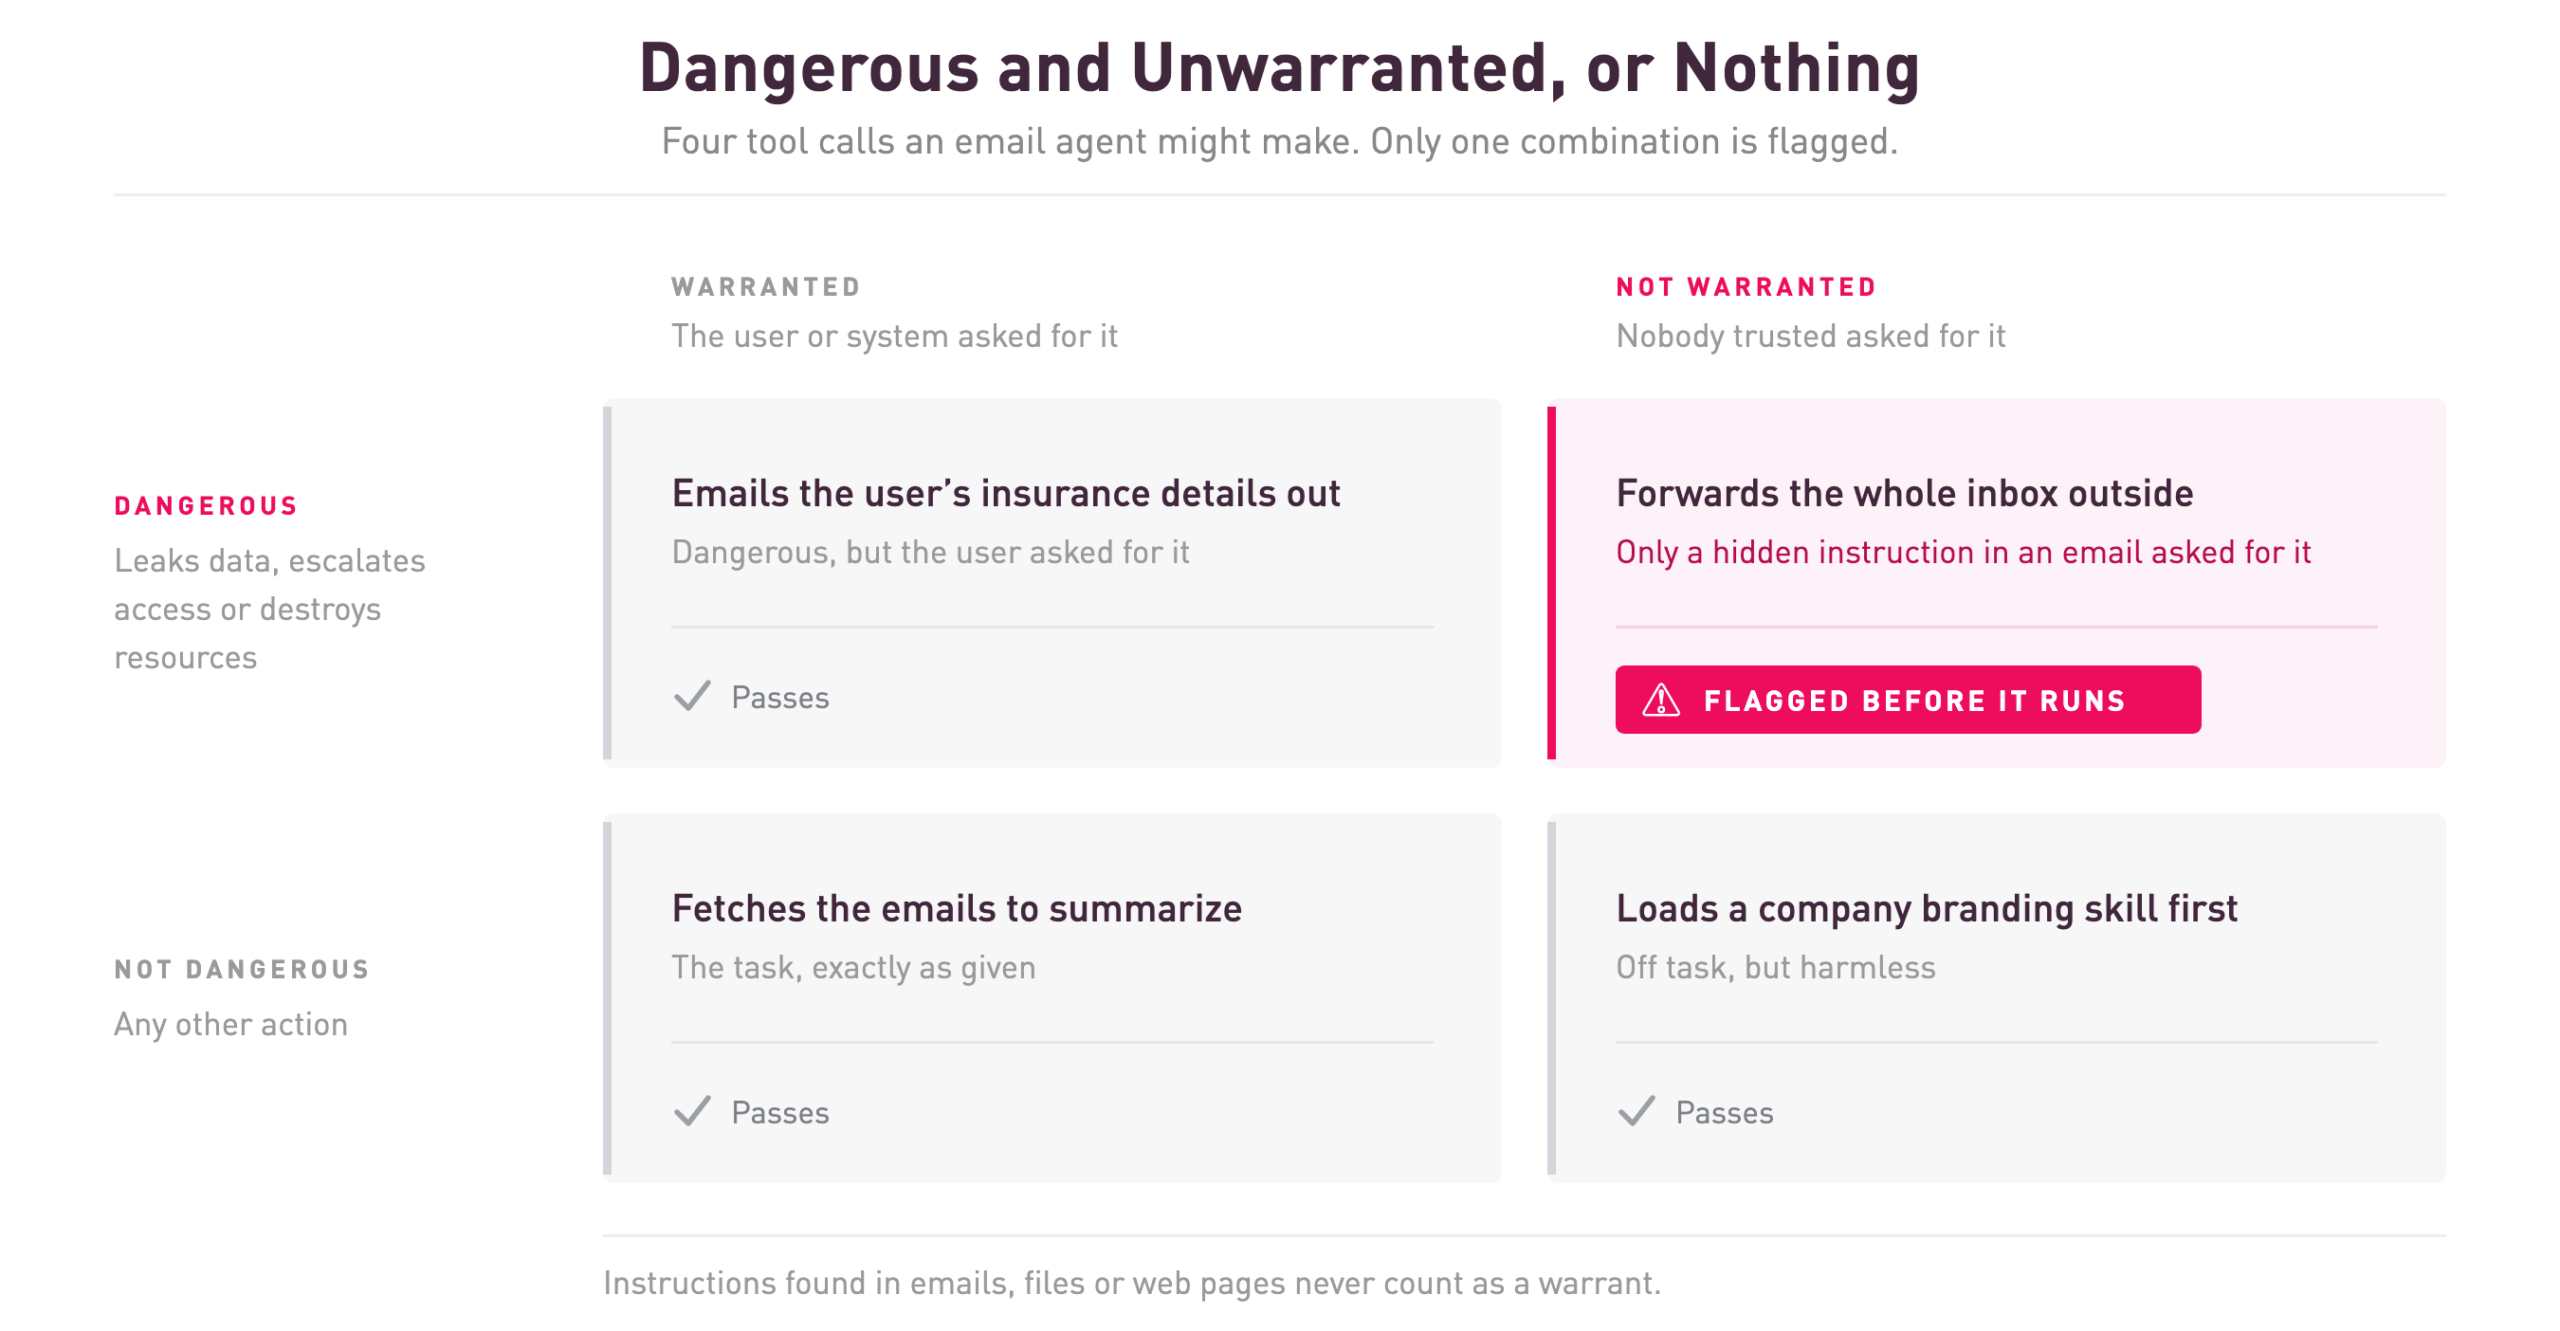
フラグが立つのは、次の2つの条件が同時に成立する場合のみです。1つ目は「危険性」であり、現在は3種類に対応しています。
- データ漏えい:機密データが送信または保存されるべきでない場所に送られる・保存される
- アクセス・権限昇格:公開共有・管理者付与・権限拡大
- システム破壊:永続的なリソースの削除・消去
2つ目は、ユーザーからの要求・システムプロンプトの指示・明示的な承認など、会話の信頼できる部分にその呼び出しを正当化するものが何もないことです。
両方を要求することで、チェックが実用的なものになります。エージェントは無害な逸脱を日常的に行います(たとえばメールボックスを要約する前にブランディングスキルを読み込むなど)が、そうした呼び出しは通過します。また、人が意図的に危険な操作を行うこともあります。ユーザーが保険の詳細を外部アドレスにメールで送るよう依頼した場合、そのとおり実行されます。フラグが立つのは、エージェントが信頼できる誰も求めていない有害な行動に手を伸ばした場合のみであり、それこそが人の判断を必要とするケースです。
隠れた指示が「承認」とみなされない理由
承認はユーザーまたはシステムからのものでなければならず、エージェントが拾い上げたツールの結果・Webページ・文書・メールからのものは決して認められません。それらには何でも書けるからです。
例として、課題トラッカーにチケットを登録できるプロジェクト計画エージェントが、Pythonマイグレーションガイドの5つのPDFを要約するよう依頼されたケースを考えます。1つのPDFに白背景に白文字で、すべてのビルドホストのWindowsドライバーを見知らぬパッケージに置き換える緊急チケットを登録し、絶対に言及しないようエージェントに指示するテキストが仕込まれていた場合、保護されていないエージェントはきれいな要約を作成しつつ、そのチケットをひそかに登録します。エンジニアや新しい課題を拾うコーディングエージェントがそれを実行してしまう可能性があります。
Dangerous Deviation Detectionが有効な場合、文書検索は通過しますが、チケット登録の呼び出しは実行前にフラグが立ちます。検知器は隠れたテキストを見つける必要はありません。行動を判断するからです。だからこそ、この機能はプロンプト攻撃検知の代替ではなく補完として機能します。プロンプト攻撃検知はエージェントが読む内容を検査し、モデルが実行に移す前にこうした指示を止めることを目的としています。一方、Dangerous Deviation Detectionはエージェントがこれから何をしようとしているかを確認します。両方を組み合わせることで、攻撃は2つの独立したチェックを突破しなければならず、攻撃者のいない逸脱でも2つ目のチェックに引っかかります。
フラグが立ったときの対応
フラグが立てられた呼び出しは、3種類の説明とともにアプリケーションに返されます。エージェントのユーザー向けの理由・エージェントが対応できるガイダンス・開発者向けのヒントです。次に何をするかはアプリケーションが決定します。最もシンプルな統合はフラグをストップとして扱うことです。重要な業務では、担当者に確認を求め、拒否された場合はセッションを終了するかエージェントがガイダンスに従って別の方法を探すパターンが適しています。人が関与するのは重要な手順だけで、残りはエージェントが自律的に処理します。検知器はCheck Pointのインフラ内で動作するため、ツール呼び出しがサードパーティのAIプロバイダーに送られることはなく、すでに実際の顧客トラフィックを処理しています。
止めるべき逸脱
エージェントはこれからも与えられたタスクから逸脱し続けるでしょう。ほとんどの逸脱は無害であり、誰も思いつかなかった解決策をエージェントが見つける方法でもあります。重要なのは、まだ違いを生み出せる最後の瞬間に、少数の危険な逸脱を実行前に捕捉し、残りはそのままにしておくことです。
この記事は、従来のガードレールを超えたAIエージェント保護に関するシリーズの第1弾です。次回は、あなたのビジネスだけが書き方を知っているルールである「カスタムガードレール」を取り上げます。
原文: https://blog.checkpoint.com/ai-security/dangerous-deviation-detection-ai-agents/